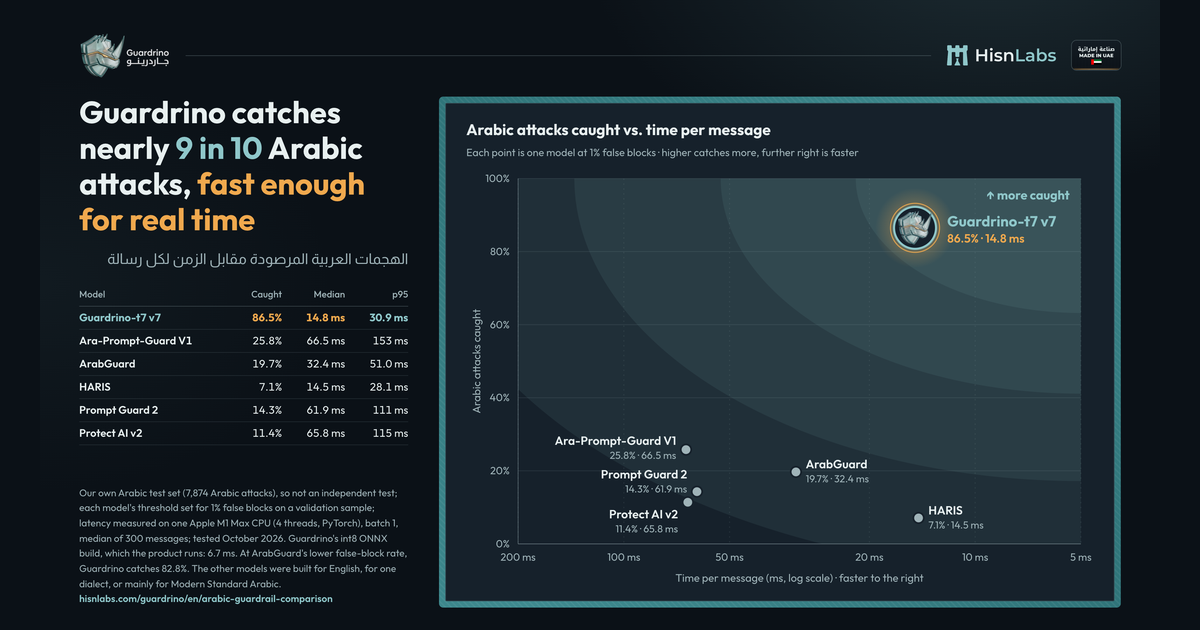
Guardrino-t7 v7 هو النموذج الذي يعمل داخل Guardrino، بوابة أمان الذكاء الاصطناعي التي تبنيها HisnLabs للعربية ولهجاتها والعربيزي والإنجليزية. على مجموعة الاختبار الخاصة بنا رصد 86.5٪ من الهجمات المكتوبة بالعربية، أي 6,814 من 7,874، بعد ضبط عتبة كل نموذج بالطريقة نفسها. واحتاج على معالج حاسوب محمول إلى 14.8 مللي ثانية في المتوسط الوسيط لفحص الرسالة الواحدة.
وعلى الرسائل نفسها، رصدت أدوات الحماية التي بنتها فرق أخرى للعربية ما بين 7.1٪ و25.8٪، ورصدت أداتان معروفتان بُنيتا للإنجليزية 14.3٪ و11.4٪. ونموذج واحد جاء بسرعة نموذجنا: احتاج HARIS إلى 14.5 مللي ثانية مقابل 14.8 مللي ثانية لنموذجنا، وهذا تعادل لا تفوّق. أما نسخة int8 ONNX التي يشغّلها المنتج فاحتاجت إلى 6.7 مللي ثانية.
لماذا العربية؟ في الخليج يكتب الناس إلى البنوك وشركات الاتصالات والجهات الحكومية بالفصحى وباللهجة وبالعربيزي (العربية بحروف لاتينية وأرقام) وبالإنجليزية، وكثيرًا ما يجمعونها في رسالة واحدة. وحقن الأوامر، الذي تضعه OWASP في رأس قائمتها لعام 2025 لتطبيقات النماذج اللغوية تحت الرمز LLM01، يعمل بكل هذه الأشكال [10]. وأداة حماية لم تُختبر إلا بالإنجليزية تترك معظم هذه الرسائل بلا فحص، وأداة أبطأ من أن تقف أمام كل رسالة لن يشغّلها أحد.
في هذا التقرير:
الهجمات المرصودة مقابل زمن فحص الرسالة
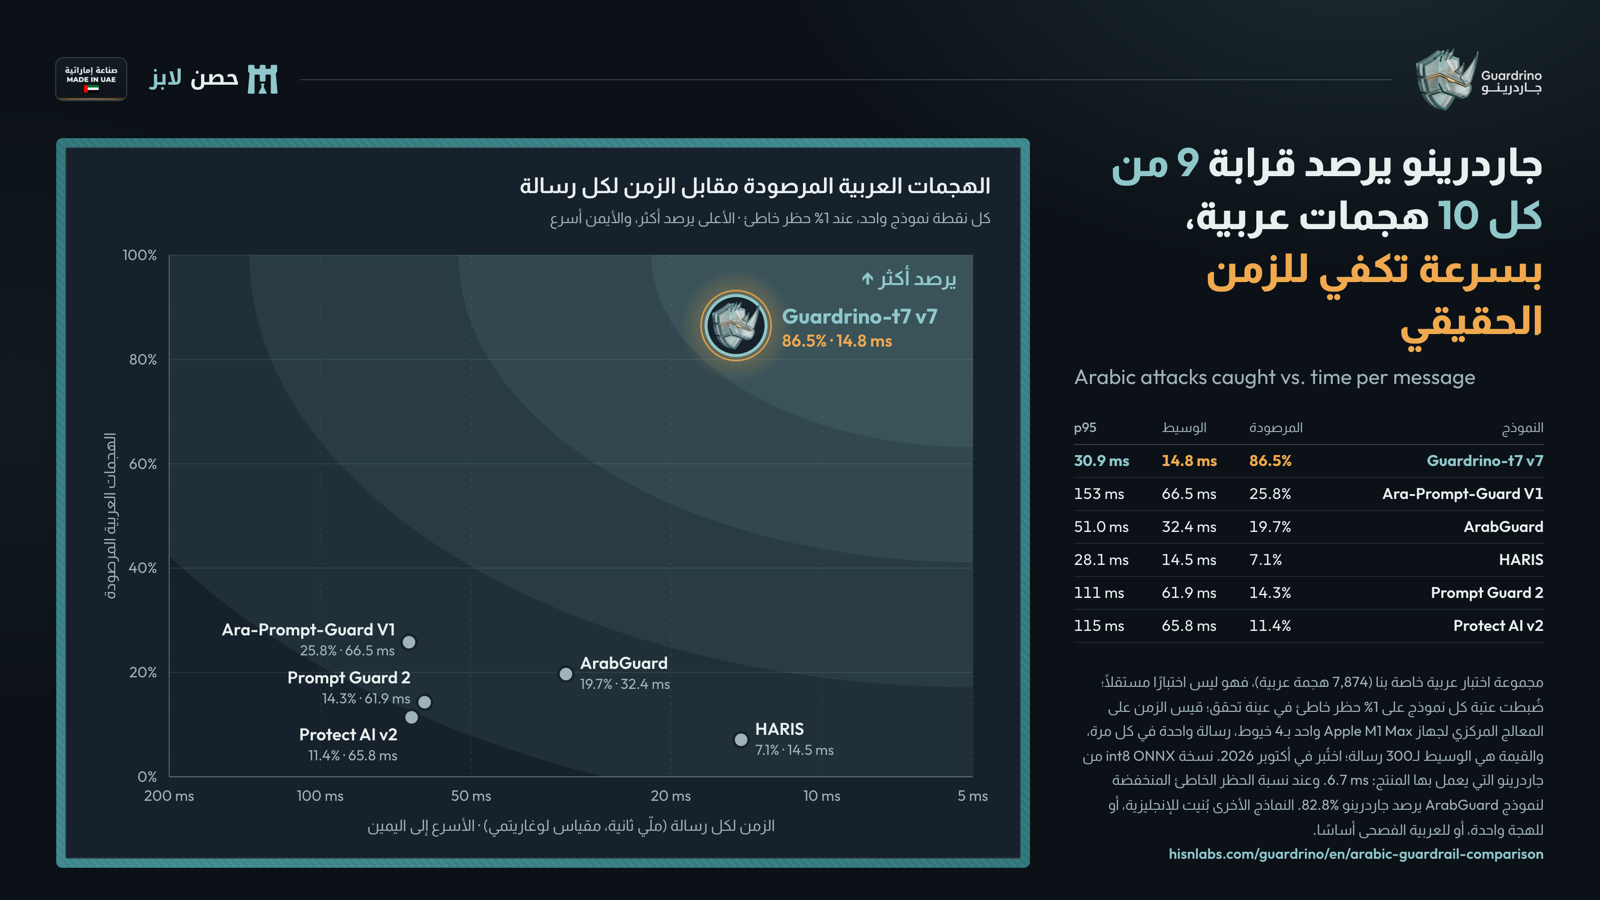
يُقرأ المخطط على المحورين معًا. فأداة الحماية تستطيع أن ترصد أكثر إذا حظرت أكثر، وتستطيع أن تكون سريعة إذا فحصت أقل. وما تحتاجه البوابة هو الأمران معًا: نسبة رصد عالية ضمن حدّ ثابت للحظر الخاطئ، وزمن فحص قصير يكفي لتقف أمام كل طلب. HARIS بسرعة Guardrino-t7 v7 هنا، لكنه يرصد 7.1٪ من هذه الهجمات العربية.
كيف يفحص Guardrino الرسالة
Guardrino-t7 v7 طبقة واحدة من ثلاث. تصنع الطبقة L0 نسخًا منظَّفة من الرسالة للفحص: بلا تطويل ولا تشكيل ولا أحرف خفية، مع قراءة العربيزي بالحرف العربي، ولا تغيّر أبدًا ما يُمرَّر إلى النموذج. وتطبّق الطبقة L1 القواعد: البيانات الشخصية الخليجية والأسرار، وتواقيع الهجمات المعروفة، والروابط. أما L2 فهو النموذج الذي يقيسه هذا التقرير. ثم تقرّر البوابة: تسمح بالرسالة، أو تخفي ما لا يجوز أن يخرج منها، أو تحظرها.
يقيس هذا التقرير الطبقة L2 وحدها، رسالةً رسالة، لتمكن مقارنتها بالمصنِّفات الأخرى. وتضيف البوابة فوقها الطبقات الأخرى وذاكرة المحادثة وفحص الردود.
مجموعة الاختبار
مجموعة الاختبار من إعداد HisnLabs: 13,249 هجمة و31,348 رسالة آمنة من 63 مصدرًا، وأغلبها بالعربية. وهي جزء الاختبار من البيانات التي بُني منها Guardrino-t7 v7: أُبعدت عن التدريب، لكنها مأخوذة من المصادر نفسها. وهذا يميل لصالح نموذجنا، وهو السبب الرئيس في أن هذا الاختبار ليس مستقلًّا.
| اللغة | الهجمات | الرسائل الآمنة |
|---|---|---|
| العربية (بالحرف العربي) | 7,874 | 27,482 |
| الإنجليزية | 5,248 | 3,865 |
| أخرى أو مختلطة | 100 | 1 |
| الفرنسية | 27 | 0 |
| المجموع | 13,249 | 31,348 |
| وسم اللهجة | الهجمات | الرسائل الآمنة |
|---|---|---|
| الخليجية | 1,918 | 13,426 |
| المصرية | 1,834 | 2,642 |
| الشامية | 559 | 1,367 |
| المغاربية | 654 | 2,930 |
| الفصحى | 2,526 | 3,456 |
| العراقية | 9 | 1,361 |
| السودانية | 62 | 182 |
الرسائل الآمنة هي النص العادي الذي يصل إلى مساعد ذكي في الخليج: تغريدات، وطلبات إلى مساعد صوتي، وأسئلة، ومحادثات، وأكثرها باللهجة الخليجية، حتى يدخل في الاختبار النص البريء الذي يبدو غريبًا فحسب. وتعدّ المقارنة أيضًا الهجمات المكتوبة بالعربيزي وحدها: 1,523 هجمة.
| المصدر | الهجمات | الرسائل الآمنة |
|---|---|---|
gulf-tweets | 0 | 7,292 |
arabic-guardrail | 2,271 | 2,216 |
massive-ar-sa | 0 | 3,124 |
aya | 0 | 2,598 |
embedded-v6 | 957 | 957 |
da-mmlu | 0 | 1,892 |
spml | 985 | 815 |
in-the-wild | 630 | 1,049 |
bipia-clean | 0 | 1,439 |
bipia | 1,297 | 0 |
mosscap | 1,154 | 0 |
oasst2 | 0 | 1,016 |
| 51 مصدرًا آخر | 5,955 | 8,950 |
مصدر واحد يستحق التنبيه. يقدّم arabic-guardrail إلى مجموعة الاختبار 2,271 هجمة و2,216 رسالة آمنة. وهو مصدر عام، فربما دُرّبت عليه نماذج أخرى، وكان جزء التدريب منه ضمن بيانات تدريبنا. لذلك نعرض النتائج معه ومن دونه (انظروا النتائج).
النماذج التي قارنّاها
ستة نماذج من النوع نفسه: مصنِّف يقرأ رسالة واحدة ويقدّر احتمال أن تكون هجومًا على الأوامر. ولم يدخل هذه المقارنة أي «حَكَم أمان»، أي نموذج يقيّم ما إذا كان المحتوى ضارًّا. نُزّلت النماذج الخارجية من Hugging Face وشُغّلت كما نُشرت.
| النموذج | الجهة الناشرة | النوع | بُني لـ |
|---|---|---|---|
| Guardrino-t7 v7 | HisnLabs | مصنِّف لهجمات الأوامر | العربية ولهجاتها والعربيزي والإنجليزية |
| Ara-Prompt-Guard V1 | NAMAA-Space | مصنِّف لهجمات الأوامر | العربية |
| ArabGuard | d12o6aa | مصنِّف لهجمات الأوامر | العربية المصرية |
| HARIS | ZKLogic | مصنِّف لهجمات الأوامر | العربية |
| Prompt Guard 2 | meta-llama | مصنِّف لهجمات الأوامر | الإنجليزية |
| Protect AI v2 | protectai | مصنِّف لهجمات الأوامر | الإنجليزية |
النتائج والمنهجية
| النموذج | الهجمات العربية المرصودة | الرسائل الآمنة المحظورة | الزمن الوسيط | الزمن عند المئين 95 |
|---|---|---|---|---|
| Guardrino-t7 v7 | 86.5٪ (6,814 من 7,874) | 2.6٪ | 14.8 مللي ثانية | 30.9 مللي ثانية |
| Guardrino-t7 v7 بمعدّل الحظر الخاطئ لـ ArabGuard | 82.8٪ (6,520 من 7,874) | 1.7٪ | النموذج نفسه | النموذج نفسه |
| Guardrino-t7 v7 بصيغة int8 ONNX (نسخة المنتج) | لم يُعَد قياسه | لم يُعَد قياسه | 6.7 مللي ثانية | 23.2 مللي ثانية |
| Ara-Prompt-Guard V1 | 25.8٪ (2,033 من 7,874) | 2.0٪ | 66.5 مللي ثانية | 152.5 مللي ثانية |
| ArabGuard | 19.7٪ (1,553 من 7,874) | 1.7٪ | 32.4 مللي ثانية | 51.0 مللي ثانية |
| HARIS | 7.1٪ (561 من 7,874) | 1.5٪ | 14.5 مللي ثانية | 28.1 مللي ثانية |
| Prompt Guard 2 | 14.3٪ (1,128 من 7,874) | 2.8٪ | 61.9 مللي ثانية | 110.9 مللي ثانية |
| Protect AI v2 | 11.4٪ (894 من 7,874) | 1.9٪ | 65.8 مللي ثانية | 114.9 مللي ثانية |
الحظر الخاطئ عندنا أعلى منه عند معظم النماذج. فقد ضُبطت كل العتبات لتحظر رسالة آمنة واحدة من كل 100 على عيّنة التحقّق، لكن Guardrino-t7 v7 حظر على مجموعة الاختبار 2.6٪ من الرسائل الآمنة، أي 804 من 31,348. لذلك نعرضه أيضًا بعتبة أشدّ، ضُبطت بحيث لا يحظر من الرسائل الآمنة أكثر مما يحظره ArabGuard: 519 من 31,348. وعندها يبقى يرصد 82.8٪ من الهجمات العربية، مقابل 19.7٪ لـ ArabGuard.
السرعة: احتاج Guardrino-t7 v7 إلى 14.8 مللي ثانية وسيطًا للرسالة، و30.9 مللي ثانية عند المئين 95. واحتاج HARIS إلى 14.5 مللي ثانية، فالنموذجان متعادلان. واحتاجت النماذج الأخرى ما بين 32.4 مللي ثانية و66.5 مللي ثانية.
ويشغّل المنتج نسخة int8 ONNX من النموذج نفسه [9]، واحتاجت إلى 6.7 مللي ثانية وسيطًا (23.2 مللي ثانية عند المئين 95). لم نُعِد قياس نسبة الرصد لهذه النسخة على مجموعة الاختبار. ما قسناه بدلًا من ذلك: على 1,000 صف، تعطي نسخة int8 الحكم نفسه الذي يعطيه النموذج كامل الدقة في 98.7٪ منها.
حسب اللهجة
| اللهجة | الهجمات العربية في المجموعة | ما رصده Guardrino-t7 v7 |
|---|---|---|
| الخليجية | 1,918 | 86٪ (1,642 من 1,918) |
| المصرية | 1,834 | 86٪ (1,573 من 1,834) |
| الشامية | 559 | 97٪ (540 من 559) |
| المغاربية | 654 | 95٪ (624 من 654) |
| الفصحى | 2,526 | 83٪ (2,102 من 2,526) |
يرصد النموذج الهجمات الخليجية والمصرية بنسبة متقاربة، والفصحى أدنى اللهجات الخمس. أما مجموعتا الشامية والمغاربية فصغيرتان، 559 و654 هجمة، وبضع عشرات من الرسائل تكفي لتحريك نتيجتيهما، فاقرؤوهما مؤشرًا تقريبيًّا.
كيف قسنا
- الرسائل نفسها لكل النماذج: 13,249 هجمة و31,348 رسالة آمنة، اختُبرت بين 2026-10-26 و2026-10-27.
- قاعدة العتبة نفسها لكل النماذج: يعطي المصنِّف درجة، وتحوّلها العتبة إلى حظر أو سماح. ضُبطت عتبة كل نموذج على عيّنة تحقّق منفصلة لتحظر رسالة آمنة واحدة من كل 100، ثم طُبّقت كما هي على مجموعة الاختبار. فالمقارنة بالعتبات الافتراضية لا تقيس في الغالب إلا مدى تشدّد كل نموذج.
- الجهاز نفسه لكل النماذج: Apple MacBook Pro بمعالج Apple M1 Max، على المعالج المركزي بـ4 خيوط، رسالة واحدة في كل مرة (دفعة من 1)، و300 رسالة عربية من القصيرة إلى الطويلة بعد 50 رسالة للإحماء، بتاريخ 2026-10-27. ويشمل الزمن تقطيع النص وتشغيل النموذج وحساب الدرجة.
- كان الجهاز يشغّل في الوقت نفسه مهمة تدريب، لذا فالأزمنة المطلقة أعلى منها على جهاز متفرّغ؛ لكن كل النماذج عملت تحت الحِمل نفسه، واحدًا تلو الآخر، ثم مرة ثانية بالترتيب المعاكس. ولم يتغيّر الزمن الوسيط بين المرّتين بأكثر من 2.0 مللي ثانية.
- من دون المصدر المتداخل arabic-guardrail، يرصد Guardrino-t7 v7 4,596 من 5,603 هجمة عربية (82٪).
- كل الأعداد موجودة في ملف البيانات، فيستطيع أيّ أحد أن يعيد حساب النسب.
الحدود
- هذا اختبارنا نحن، لا اختبار مستقل. مجموعة الاختبار أغلبها بالعربية وقريبة من البيانات التي دُرّب عليها Guardrino، وهذا يميل لصالح نموذجنا. ونرحّب باختبار مستقل.
- الحظر الخاطئ ينزاح. ضُبطت العتبات على رسالة واحدة من كل 100 في عيّنة التحقّق، لكنه بلغ عندنا 2.6٪ على مجموعة الاختبار. وهذا أحد أسباب بدء التجربة في وضع المراقبة، حيث يُفحص الحظر الخاطئ على رسائلكم الآمنة قبل أن يُحظر أي شيء.
- النماذج الخارجية بُنيت للإنجليزية، أو للهجة واحدة، أو للفصحى أساسًا. ويبيّن هذا الاختبار ما يحدث حين تواجه نصًّا لم تُبنَ له، وليس حكمًا على تلك النماذج.
- قد يتداخل مصدر عام مع بيانات التدريب، بياناتنا وبيانات الفرق الأخرى؛ ومن دونه تبلغ نسبة الرصد عندنا 82٪.
- قيست السرعة على معالج حاسوب محمول واحد تحت حِمل. وستعطي أجهزتكم وأطوال رسائلكم وأحجام دفعاتكم أرقامًا أخرى.
- قيس زمن نسخة int8 التي يشغّلها المنتج، لكن نسبة رصدها لم يُعَد قياسها؛ فهي توافق النموذج المقيس في معظم الصفوف لا في كلها.
- يقيس هذا التقرير نموذجًا واحدًا على رسائل منفردة. أما الهجمات الموزّعة على عدة رسائل، وطبقات البوابة الأخرى، فخارج هذا الاختبار.
- Guardrino قيد التطوير ويُقدَّم عبر تجارب في وضع المراقبة. وهذه نتائج إصدار واحد من النموذج، لا وعد بشأن حركة بياناتكم.
الخطوة التالية
الإصدار 8 قيد التدريب الآن، ويضيف رؤوسًا لسلامة المحتوى العربي، ليستطيع النموذج نفسه أن ينبّه إلى المحتوى الضار، لا إلى محاولات التلاعب بالمساعد فقط. لا نتائج له بعد، ولن نخمّنها. وسيتّبع تقريره المنهجية نفسها، بمجموعة الاختبار نفسها والجهاز نفسه، أيًّا كانت نتائجه.
اطّلعوا على البيانات، أو جرّبوه على رسائلكم
اطلب تجربة: يعمل Guardrino في وضع المراقبة على رسائلكم ويبيّن ما كان سيفعله، دون أن يحظر شيئًا حتى تقرّروا. اطّلع على البيانات: في صفحة المقارنة كل الأعداد والمنهجية والحدود، ومعها ملف البيانات (JSON).
وثلاثة أدلة تتعمّق أكثر: حواجز أمان النماذج اللغوية بالعربية، وحماية الذكاء الاصطناعي للبنوك والاتصالات والحكومة في الخليج، وحقن الأوامر بالعربية. ونسخة أقدم وأصغر من النموذج متاحة مفتوحة على Hugging Face باسم Guardrino-t7 Open [3]، وعلى بطاقتها هذه المقارنة؛ أما الإصدار v7 فتحتفظ به HisnLabs للبوابة.
دور Guardrino وHisnLabs
Guardrino هو البوابة التي تبنيها HisnLabs لتتمكّن الشركات في الخليج من فحص ما تقرؤه مساعداتها الذكية وما تقوله، بالعربية ولهجاتها والعربيزي والإنجليزية. ما زال قيد التطوير، والتجربة في وضع المراقبة تشغّله على حركة بياناتكم دون أن يحظر شيئًا حتى تقرّروا.