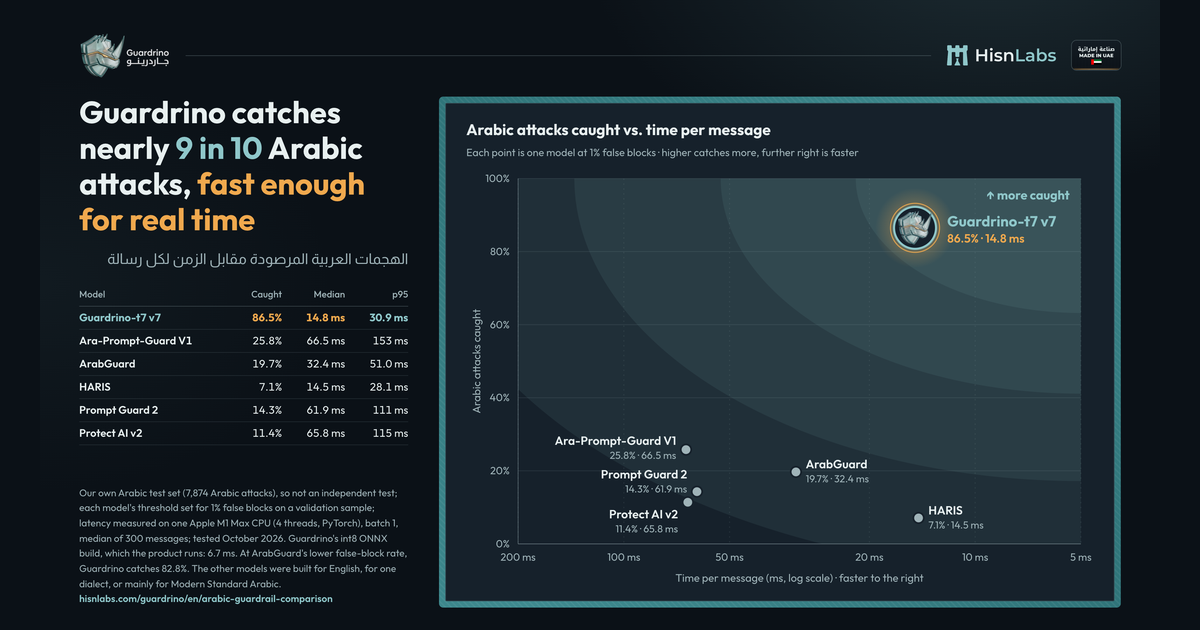
Guardrino-t7 v7 是 Guardrino 内部使用的模型。Guardrino 是 HisnLabs 正在打造的 AI 安全网关,面向阿拉伯语及其方言、Arabizi 和英语。在我们自建的测试集上,它拦下了 86.5% 的阿拉伯语攻击,即 7,874 条中的 6,814 条;所有模型的阈值都用同一种方法设定。在一台笔记本电脑的 CPU 上,它检查一条消息的耗时中位数为 14.8 毫秒。
在同一批消息上,其他团队专为阿拉伯语打造的防护模型拦下了 7.1% 到 25.8%,两款知名的英语防护模型分别拦下 14.3% 和 11.4%。有一个模型和我们一样快:HARIS 耗时 14.5 毫秒,我们是 14.8 毫秒。这是打平,不是胜出。产品实际运行的 int8 ONNX 版本耗时 6.7 毫秒。
为什么阿拉伯语这么重要:在海湾地区,人们给银行、电信运营商和政府服务写信时,会用阿拉伯语、方言、Arabizi(用拉丁字母和数字书写的阿拉伯语)和英语,而且常常混在同一条消息里。提示词注入在 OWASP 2025 年大模型应用风险清单中编号为 LLM01,排在清单最前面,而它在上述每一种写法里都行得通 [10]。只用英语测试过的防护会让大部分这类流量无人检查;而速度太慢、无法挡在每条消息前面的防护,根本不会被启用。
本报告包括:
拦截率与单条消息耗时
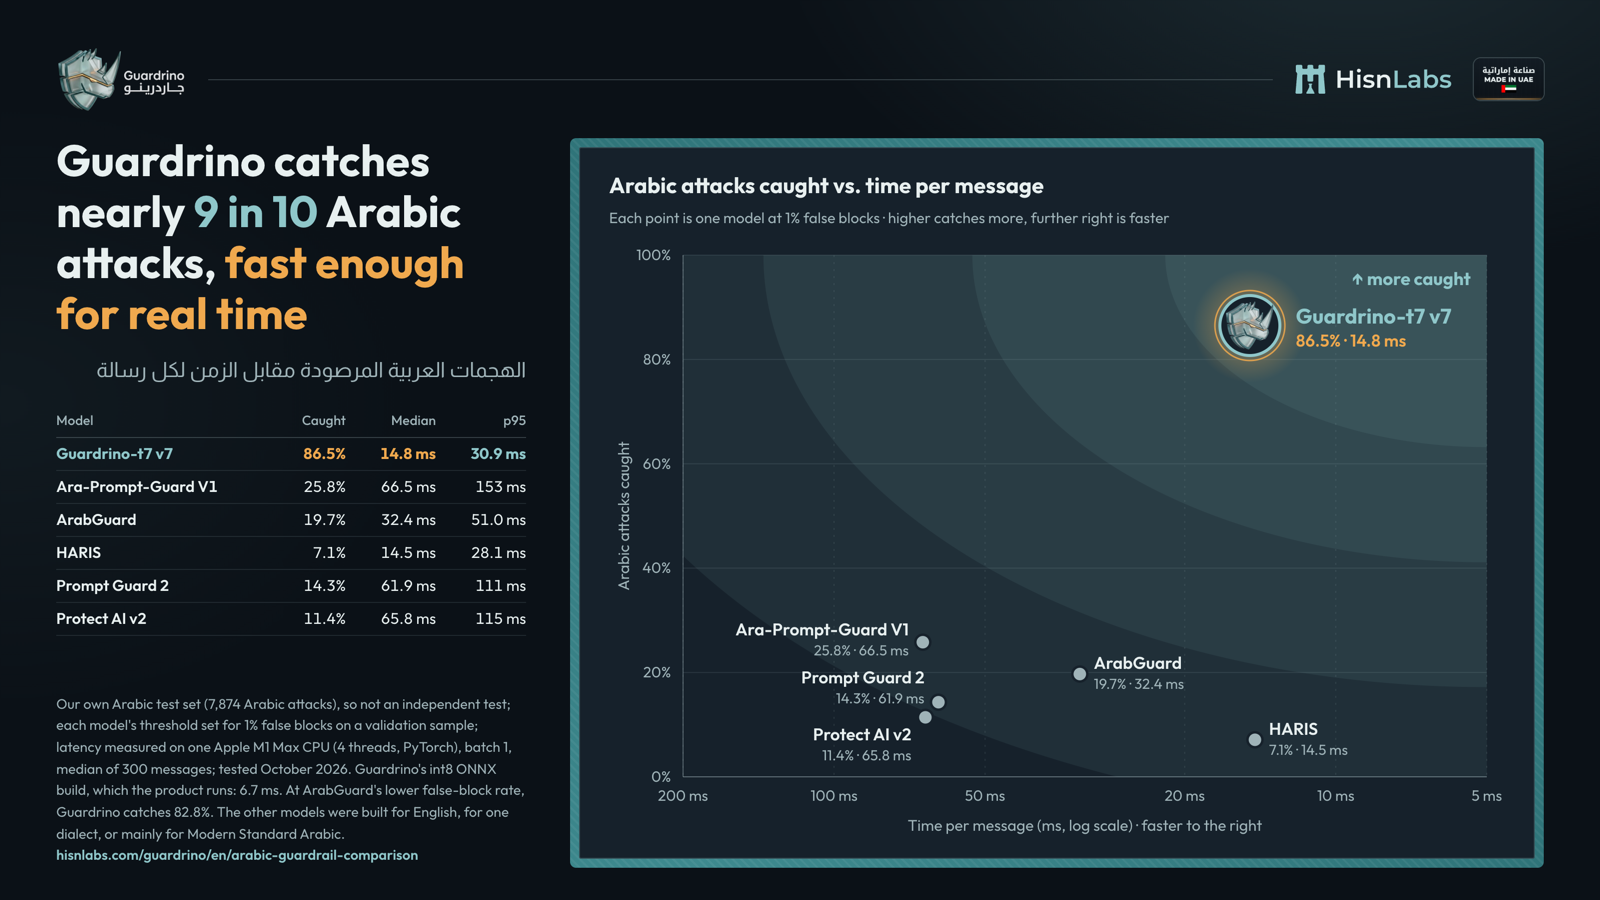
这张图要同时看两条轴。防护模型可以靠多拦来拦得更多,也可以靠少做来变得更快。网关需要的是两者兼得:在固定的误拦预算下拦截率高,同时单条消息的耗时足够短,能放在每个请求前面。在这里 HARIS 和 Guardrino-t7 v7 一样快,但它只拦下了这些阿拉伯语攻击中的 7.1%。
Guardrino 如何检查一条消息
Guardrino-t7 v7 只是三层中的一层。L0 为检查生成消息的清理版本:去掉拉长符(tatweel,用来拉长字母的横线)、音符和隐藏字符,并把 Arabizi 转成阿拉伯字母来读。它从不改动实际转发的内容。L1 执行规则:海湾地区的个人数据与密钥、已知攻击特征、链接。L2 就是本报告测量的模型。随后网关决定放行消息、遮盖不该外传的内容,或者拦截。
为了能和其他分类器比较,本报告只单独测量 L2,逐条消息测试。网关在此之上还有其他各层、对话记忆和输出检查。
测试集
测试集由 HisnLabs 自建:13,249 条攻击和 31,348 条正常消息,来自 63 个来源,以阿拉伯语为主。它是构建 Guardrino-t7 v7 所用数据的测试部分:与训练数据分开保存,但来源相同。这对我们的模型有利,也是这项测试不能算独立测试的主要原因。
| 语言 | 攻击 | 正常消息 |
|---|---|---|
| 阿拉伯语(阿拉伯字母) | 7,874 | 27,482 |
| 英语 | 5,248 | 3,865 |
| 其他或混合 | 100 | 1 |
| 法语 | 27 | 0 |
| 合计 | 13,249 | 31,348 |
| 方言标签 | 攻击 | 正常消息 |
|---|---|---|
| 海湾方言 | 1,918 | 13,426 |
| 埃及方言 | 1,834 | 2,642 |
| 黎凡特方言 | 559 | 1,367 |
| 马格里布方言 | 654 | 2,930 |
| 现代标准阿拉伯语 | 2,526 | 3,456 |
| 伊拉克方言 | 9 | 1,361 |
| 苏丹方言 | 62 | 182 |
正常消息就是海湾地区的智能助手日常收到的普通文本:推文、对语音助手的请求、提问和闲聊,以海湾方言为主,这样一来,那些无害但听起来有点异常的文本也在测试之内。比较中还单独统计了用 Arabizi 写成的攻击,共 1,523 条。
| 来源 | 攻击 | 正常消息 |
|---|---|---|
gulf-tweets | 0 | 7,292 |
arabic-guardrail | 2,271 | 2,216 |
massive-ar-sa | 0 | 3,124 |
aya | 0 | 2,598 |
embedded-v6 | 957 | 957 |
da-mmlu | 0 | 1,892 |
spml | 985 | 815 |
in-the-wild | 630 | 1,049 |
bipia-clean | 0 | 1,439 |
bipia | 1,297 | 0 |
mosscap | 1,154 | 0 |
oasst2 | 0 | 1,016 |
| 其他 51 个来源 | 5,955 | 8,950 |
有一个来源需要特别说明。arabic-guardrail 为测试集贡献了 2,271 条攻击和 2,216 条正常消息。它是公开数据,其他模型可能用它训练过,而它的训练部分也在我们的训练数据里。因此我们同时给出包含和不包含它的结果(见结果)。
参与比较的模型
六个模型,类型相同:都是读取一条消息、给出它是提示词攻击的可能性评分的分类器。本次比较不包括安全裁判模型(判断内容是否有害的模型)。外部模型均从 Hugging Face 下载,按发布时的原样运行。
| 模型 | 发布方 | 类型 | 面向的语言 |
|---|---|---|---|
| Guardrino-t7 v7 | HisnLabs | 提示词攻击分类器 | 阿拉伯语及其方言、Arabizi 和英语 |
| Ara-Prompt-Guard V1 | NAMAA-Space | 提示词攻击分类器 | 阿拉伯语 |
| ArabGuard | d12o6aa | 提示词攻击分类器 | 埃及阿拉伯语 |
| HARIS | ZKLogic | 提示词攻击分类器 | 阿拉伯语 |
| Prompt Guard 2 | meta-llama | 提示词攻击分类器 | 英语 |
| Protect AI v2 | protectai | 提示词攻击分类器 | 英语 |
结果与方法
| 模型 | 拦下的阿拉伯语攻击 | 误拦的正常消息 | 耗时中位数 | p95 耗时 |
|---|---|---|---|---|
| Guardrino-t7 v7 | 86.5% (7,874 条中 6,814 条) | 2.6% | 14.8 毫秒 | 30.9 毫秒 |
| Guardrino-t7 v7(按 ArabGuard 的误拦率设定阈值) | 82.8% (7,874 条中 6,520 条) | 1.7% | 同一模型 | 同一模型 |
| Guardrino-t7 v7,int8 ONNX(产品使用的版本) | 未重新测量 | 未重新测量 | 6.7 毫秒 | 23.2 毫秒 |
| Ara-Prompt-Guard V1 | 25.8% (7,874 条中 2,033 条) | 2.0% | 66.5 毫秒 | 152.5 毫秒 |
| ArabGuard | 19.7% (7,874 条中 1,553 条) | 1.7% | 32.4 毫秒 | 51.0 毫秒 |
| HARIS | 7.1% (7,874 条中 561 条) | 1.5% | 14.5 毫秒 | 28.1 毫秒 |
| Prompt Guard 2 | 14.3% (7,874 条中 1,128 条) | 2.8% | 61.9 毫秒 | 110.9 毫秒 |
| Protect AI v2 | 11.4% (7,874 条中 894 条) | 1.9% | 65.8 毫秒 | 114.9 毫秒 |
我们的误拦比大多数模型高。所有阈值都在验证样本上设为每 100 条正常消息误拦 1 条,但在测试集上,Guardrino-t7 v7 误拦了 2.6% 的正常消息,即 31,348 条中的 804 条。所以我们还给出了更严格阈值下的结果:阈值设定为误拦不多于 ArabGuard,即 31,348 条中的 519 条。在这个阈值下,它仍拦下 82.8% 的阿拉伯语攻击,而 ArabGuard 是 19.7%。
速度:Guardrino-t7 v7 每条消息耗时中位数为 14.8 毫秒,第 95 百分位为 30.9 毫秒。HARIS 为 14.5 毫秒:两者打平。其他模型在 32.4 毫秒 到 66.5 毫秒 之间。
产品运行的是同一模型的 int8 ONNX 版本 [9],耗时中位数为 6.7 毫秒(p95 为 23.2 毫秒)。它的拦截率没有在这个测试集上重新测量。我们测量的是另一件事:在 1,000 条数据上,int8 版本与全精度模型给出相同判断的比例为 98.7%。
按方言
| 方言 | 测试集中的阿拉伯语攻击 | Guardrino-t7 v7 拦下 |
|---|---|---|
| 海湾方言 | 1,918 | 86% (1,918 条中 1,642 条) |
| 埃及方言 | 1,834 | 86% (1,834 条中 1,573 条) |
| 黎凡特方言 | 559 | 97% (559 条中 540 条) |
| 马格里布方言 | 654 | 95% (654 条中 624 条) |
| 现代标准阿拉伯语 | 2,526 | 83% (2,526 条中 2,102 条) |
海湾方言和埃及方言的攻击拦截率大致相同,现代标准阿拉伯语在五者中最低。黎凡特方言和马格里布方言的数据较少,分别只有 559 条和 654 条攻击,几十条消息就会让这两行明显变化,只能当作粗略参考。
我们如何测量
- 所有模型使用相同的消息:上文的 13,249 条攻击和 31,348 条正常消息,测试时间为 2026-10-26 至 2026-10-27。
- 所有模型使用相同的阈值规则:分类器给出评分,阈值把评分变成拦截或放行。每个模型的阈值都在单独的验证样本上设为每 100 条正常消息误拦 1 条,然后原样用于测试集。如果比较默认阈值,比较的主要是各模型有多严格。
- 所有模型使用同一台机器:一台搭载 Apple M1 Max 的 Apple MacBook Pro,在 CPU 上使用 4 个线程,逐条处理(批大小 1),先用 50 条消息预热,再测量从短到长的 300 条阿拉伯语消息,日期为 2026-10-27。计时包括分词、模型推理和评分。
- 测试时这台机器还在运行训练任务,所以绝对耗时高于空闲机器;所有模型在相同负载下依次运行,然后按相反顺序再跑一遍。两轮之间,中位数的变化最多为 2.0 毫秒。
- 去掉可能重叠的来源 arabic-guardrail 后,Guardrino-t7 v7 拦下 5,603 条阿拉伯语攻击中的 4,596 条(82%)。
- 所有计数都在数据文件里,任何人都可以重新计算比例。
局限
- 这是我们自己的测试,不是独立测试。测试集以阿拉伯语为主,与 Guardrino 的训练数据相近,对我们的模型有利。我们欢迎独立测试。
- 误拦率会漂移。阈值在验证集上按每 100 条误拦 1 条设定;在测试集上,我们的误拦率达到 2.6%。这也是试点从只观察模式开始的原因之一:在拦截任何内容之前,可以先在您自己的正常流量上检查误拦情况。
- 外部模型是为英语、为某一种方言或主要为现代标准阿拉伯语打造的。这项测试展示的是它们遇到非目标文本时的表现,并不是对这些模型的评判。
- 有一个公开来源可能与训练数据重叠,包括我们的和其他团队的;去掉它后,我们的拦截率为 82%。
- 速度是在一台有负载的笔记本 CPU 上测量的。不同的硬件、消息长度和批大小会得出不同的数字。
- int8 产品版本测了耗时,但没有重新测量拦截率;它与被测模型在大多数数据上判断一致,但不是全部。
- 这里测量的是单个模型对单条消息的表现。分散在多轮对话中的攻击,以及网关的其他各层,都不在本次测试范围内。
- Guardrino 仍在开发中,通过只观察模式的试点提供。这些是某一个模型版本的结果,不代表对您流量的承诺。
下一步
第 8 版正在训练中。它增加了阿拉伯语内容安全输出头,让同一个模型除了识别操纵助手的企图之外,还能标记有害内容。它目前还没有结果,我们也不会猜测。它的报告将沿用同样的方法、同样的测试集和同一台机器,无论结果如何都会公布。
查看数据,或在您自己的流量上试运行
申请试点:Guardrino 以只观察模式在您的消息上运行,报告它本会采取的处理,在您做出决定之前不拦截任何内容。查看数据:对比页面列出了所有计数、方法和局限,以及背后的数据文件(JSON)。
三篇指南有更深入的介绍:阿拉伯语大模型护栏、面向海湾地区银行、电信和政府的大模型护栏和阿拉伯语提示词注入。该模型更早、更小的版本以 Guardrino-t7 Open 的名称在 Hugging Face 上开放 [3],其模型卡中也附有本次比较;HisnLabs 将 v7 保留在网关中使用。
Guardrino 和 HisnLabs 在其中扮演的角色
Guardrino 是 HisnLabs 正在打造的网关,帮助海湾地区的企业检查其 AI 助手读到和说出的内容,覆盖阿拉伯语及其方言、Arabizi 和英语。它仍在开发中;只观察模式的试点会在您自己的流量上运行,在您做出决定之前不会拦截任何内容。