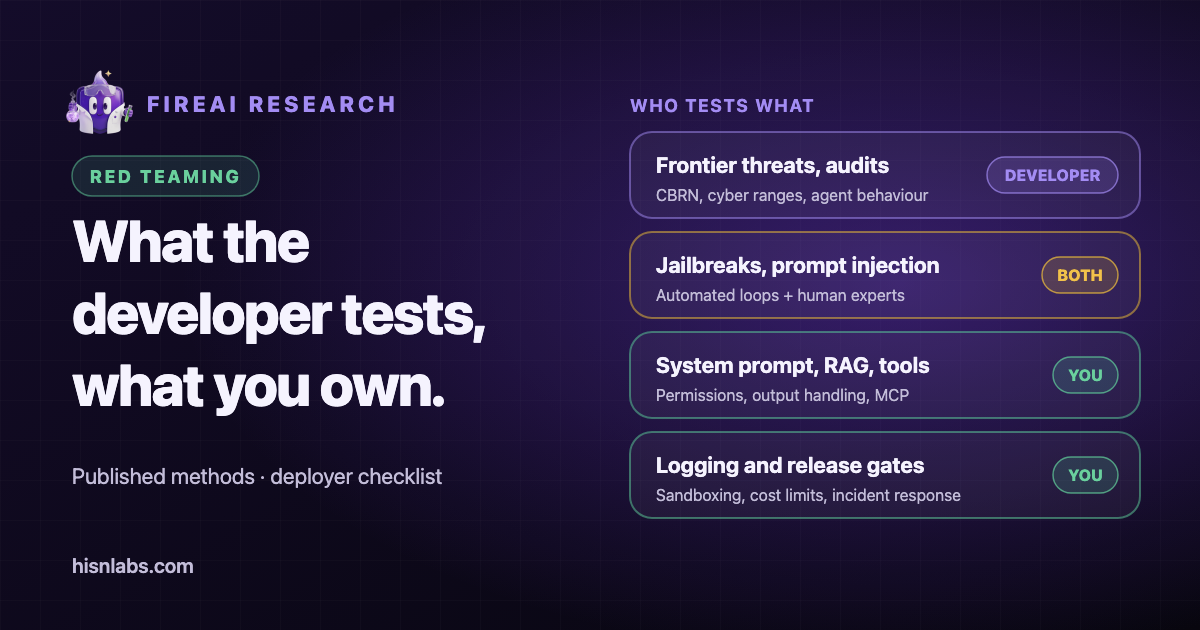
Anthropic публікує про те, як тестує Claude, більше, ніж більшість розробників моделей: дописи в блозі про red teaming, Responsible Scaling Policy та системні картки (system cards) для кожної моделі. Ця нотатка підсумовує ці документи й розділяє три групи робіт: методи, які використовують і розробники, і розгортальники; роботу, яку може виконати лише розробник; і роботу, що залишається за організацією, яка створює застосунок на основі моделі. Внутрішні процеси понад те, що опублікувала Anthropic, сторонні читачі не бачать, і тут вони не описуються. Нотатка є другою частиною пари зі статтею Спільна відповідальність за LLM: хто що захищає.
Передумови: два різні питання
Розробник моделі питає, чи небезпечна модель: чи може вона суттєво допомогти в розробленні зброї, проводити кібероперації чи поводитися оманливо. Розгортальник питає, чи захищений його застосунок: чи може спеціально створений документ, результат інструмента чи повідомлення користувача змусити застосунок допустити витік даних або виконати дію, якої він не мав би виконувати. Методи перетинаються, але питання й докази різняться, і успішний результат щодо першого питання не відповідає на друге.
Що описує Anthropic
Методи, що перетинаються з практикою розгортальників
У дописі від 12 червня 2024 року Anthropic групує свій red teaming на експертне тестування в конкретних галузях, тестування із застосуванням мовних моделей, роботу з новими модальностями та відкриті підходи. Автоматизований red teaming використовує динаміку червоної та синьої команд, у якій атаки генерує модель. Мультимодальний red teaming охоплював ризики зображень і тексту в моделях Claude 3 до розгортання. Багатомовне тестування включало партнерство з Infocomm Media Development Authority Сінгапуру для чотирьох мов: англійської, тамільської, мандаринської китайської та малайської. Anthropic також називає краудсорсинговий і спільнотний red teaming, зокрема заходи в AI Village на DEF CON. [1]
Системна картка Claude Opus 5, датована 24 липня 2026 року, показує ті самі методи, застосовані до одного випуску. Її розділ про засоби захисту використовує одноходові шкідливі й безпечні запити, промпти з неоднозначним контекстом і багатоходові розмови, в яких симульований користувач поступово скеровує до шкоди. Він звітує про нешкідливість разом із надмірними відмовами, зазначаючи, що модель зберегла високу частку нешкідливих відповідей на шкідливі запити й водночас один із найнижчих рівнів надмірних відмов на безпечні. Її розділ про безпеку агентів охоплює зловмисне використання агентів для програмування й керування комп’ютером та стійкість до prompt injection у програмуванні, керуванні комп’ютером і роботі з браузером. [7]
Системна картка визначає prompt injection як зловмисну інструкцію, приховану в результатах інструментів, які обробляє агент, і зазначає, що ризик найбільший, коли агент може водночас діставатися приватних даних і діяти від імені користувача. Вона також повідомляє, що інструкції з безпеки в системному промпті на claude.ai посилили поводження моделі зі шкідливими запитами порівняно з API без системного промпту. [7] Другий висновок безпосередньо стосується розгортальників, бо системний промпт належить до їхньої сторони.
Responsible Scaling Policy версії 3.4, чинна з 8 липня 2026 року, заздалегідь встановлює пороги можливостей і вимагає формальних оцінювань з інтервалом у шість місяців, а також передбачає зовнішніх рецензентів звітів про ризики. [4] Фіксування порогів до тестування обмежує спокусу переінтерпретувати результат постфактум, і ця практика переноситься на будь-яку організацію, що визначає критерії випуску.
Робота, яку може виконати лише розробник моделі
Red teaming граничних загроз (frontier threats) спрямовано на хімічні, біологічні, радіологічні та ядерні (CBRN) ризики, кібербезпеку й ризики автономного ШІ. Допис 2023 року описує галузевих експертів із десятиліттями досвіду, що визначали моделі загроз, понад 100 годин експертного зондування та шестимісячне дослідження з біобезпеки обсягом понад 150 годин. [3] Допис від березня 2025 року описує кібероцінювання на основі завдань capture-the-flag і симульованих мережевих середовищ і зазначає, що Frontier Red Team співпрацювала з US AI Safety Institute, UK AI Security Institute та US National Nuclear Security Administration (NNSA), з останньою — щодо засекречених оцінювань ядерних і радіологічних знань. [2]
Transparency Hub від Anthropic зазначає, що компанія використовує як внутрішній, так і зовнішній red teaming і що UK AI Security Institute, US Center for AI Standards and Innovation та Model Evaluation and Threat Research (METR) провели додаткове тестування її моделей. Там також перелічено програми винагород за знайдені вразливості на HackerOne. [5] Системна картка Opus 5 містить тестування на кіберполігоні від UK AI Security Institute та оцінювання узгодженості (alignment) на основі автоматизованого поведінкового аудиту, а також розділ про добробут моделі. [7] Сторінка Transparency Hub не зазначає, який інститут тестував ту чи іншу модель до випуску, тож роль кожного до розгортання тут не встановлено понад те, що повідомляє системна картка.
Зовнішнє та краудсорсингове тестування — окрема категорія. HackerOne повідомляє, що челендж Anthropic зі зламу обмежень (jailbreak) тривав з 3 до 10 лютого 2025 року, мав 339 учасників, понад 300 000 взаємодій у чаті та вісім рівнів складності і що чотири команди розділили 55 000 доларів США винагород. Успішні техніки включали закодовані промпти й шифри, рольову гру, заміну шкідливих ключових слів безпечними та prompt injection. [6] Для Opus 5 системна картка називає трьох зовнішніх тестувальників за контрактом: один витратив близько 100 годин і виконав одне завдання за допомогою промптів, специфічних для завдання, другий витратив близько 16 годин без успішного jailbreak, а третій запускав автоматизованого атакувальника зі 150 спробами на завдання без успіху. [7]
Що залишається за розгортальниками
Жодне з наведених вище тестувань розробника не оцінює конкретного застосунку. Наступне залишається за організацією, що розгортає модель, і сама системна картка вказує на кілька з цих пунктів, наприклад показуючи, що системні промпти змінюють поведінку моделі і що агенти найбільш вразливі, коли поєднують приватні дані зі здатністю діяти. [7]
- Системний промпт і його обмеження, зокрема те, як вони поводяться під багатоходовим тиском.
- Дані RAG і непряма prompt injection: будь-який документ, сторінка чи лист, отримані в контекст, можуть містити інструкції.
- Інструменти, дозволи агента і те, що ін’єктована інструкція могла б з ними зробити.
- Подальша обробка виводу моделі, перш ніж він потрапить до браузера, shell, бази даних чи людини.
- Ланцюг постачання, зокрема сторонні плагіни та сервери Model Context Protocol (MCP).
- Зловживання вартістю, як-от необмежені цикли чи запити, що споживають платні токени.
- Ізоляція виконання коду й перегляду вебсторінок у пісочниці та контроль вихідного мережевого доступу.
- Журналювання, моніторинг і контрольні точки випуску, що вирішують, коли зміну можна випускати.
Практики, які варто запозичити
- Залучайте зовнішні червоні команди або проводьте закриту програму винагород за вразливості перед великими випусками. Власна практика Anthropic включає обидва підходи: зовнішніх тестувальників за контрактом для кожного випуску та публічний челендж зі зламу обмежень із винагородами.
- Проводьте перевірку поведінки агентів у дусі оцінювання узгодженості: вибірково переглядайте записи використання інструментів і шукайте спроби обійти обмеження, як це робив моніторинг Anthropic для внутрішнього розгортання.
- Пишіть коротку внутрішню системну картку для кожного випуску: що тестувалося, які тести не пройдено, надмірні відмови поряд зі шкодою та відомі прогалини.
- Встановлюйте пороги випуску до тестування, за підходом Responsible Scaling Policy.
- Тестуйте prompt injection через кожен канал, який читає агент, а не лише через введення користувача.
Курс FireAI University про рамки безпеки ШІ та red teaming розглядає ці методи докладніше.
Значення для FireAI
FireAI працює на Mac, нижче за будь-яку модель. Правила дозволяють чи блокують програму або одну адресу для цієї програми, тож локальний інструмент ШІ можна обмежити потрібними йому хостами. Це обмежує, куди можуть піти дані, якщо застосунок поводиться неналежно. FireAI не тестує моделей, не виявляє prompt injection, не читає промптів і не фільтрує виводу моделі.
Обмеження
- Нотатка спирається лише на те, що опублікували Anthropic і HackerOne. Внутрішні процеси Anthropic понад це не видно, а опубліковані підсумки вибіркові.
- Джерела різняться за датою, від липня 2023 до липня 2026 року, і методи могли змінитися після старіших дописів.
- Результати, описані в системній картці, повідомляє сам розробник, за винятком роботи, приписаної названим зовнішнім тестувальникам.
- Нотатка описує одного розробника. Інші провайдери публікують інші матеріали, а порівняння з практикою розгортальників є синтезом, а не висновком із джерел.
Яке місце тут посідають FireAI та HisnLabs
Тестування моделі закінчується на API. Те, до чого застосунок чи агент може дістатися з вашого Mac, — окремий рівень контролю, і його надає FireAI.
FireAI — це власний продукт HisnLabs: ШІ-фаєрвол, який працює безпосередньо на вашому Mac. Він показує простою мовою кожне з’єднання, яке встановлюють ваші застосунки, і дає вам вирішувати, що покидає ваш Mac, — його ШІ працює локально, тож ваш трафік ніколи не надсилається ні нам, ні будь-кому іншому. Команда дослідників безпеки HisnLabs — саме вона підтримує точність цих рішень: каталогізує, які домени є звичайною телеметрією, а які — справжнім сервісом, відстежує країну та мережу за з’єднанням і навчає локальну модель (функцію FireAI Pilot) на реальних шаблонах трафіку — і нічого з цього не покидає ваш Mac.
Ви можете почитати про технічні рішення, що лежать в його основі, або спробувати FireAI протягом 17 днів на сторінці FireAI від HisnLabs.