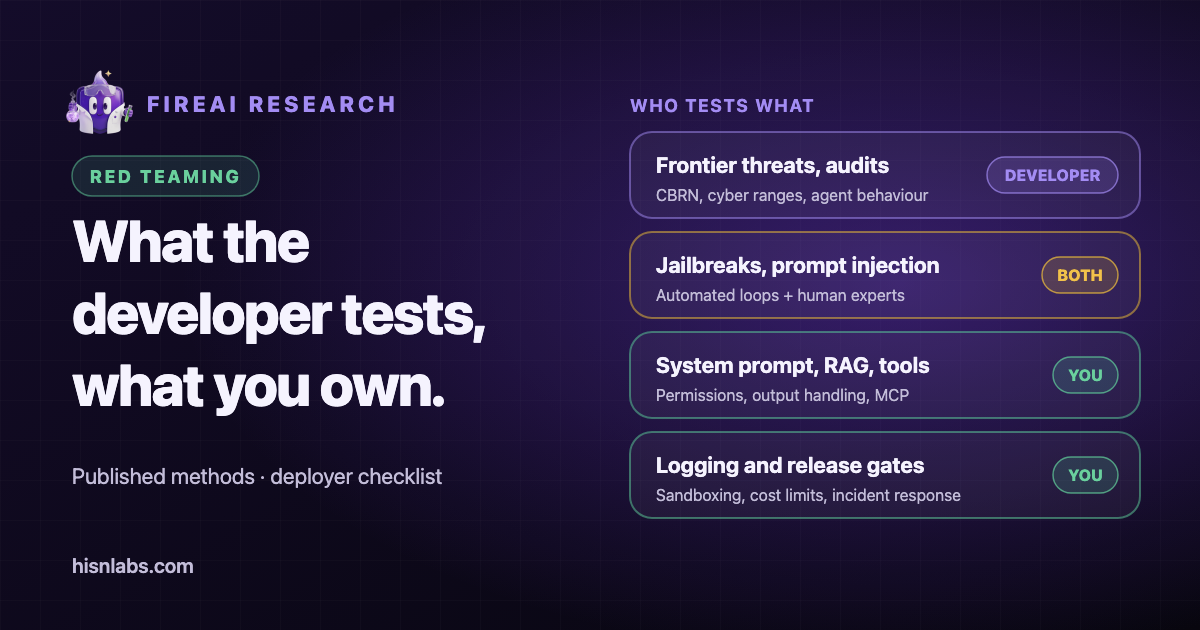
与大多数模型开发者相比,Anthropic 公开了更多关于如何测试 Claude 的内容:关于红队测试的博客文章、负责任扩展政策(Responsible Scaling Policy),以及每个模型的系统卡。本文总结这些文件,并把工作分为三组:开发者和部署者都会使用的方法、只有开发者才能完成的工作,以及仍由基于该模型构建应用的组织负责的工作。Anthropic 未公开的内部流程,外部读者无从得知,本文也不作描述。本文是 Shared responsibility for LLMs: who secures what 的姊妹篇,构成其下半部分。
背景:两个不同的问题
模型开发者问的是模型是否危险:它能否为武器开发提供实质性助力、能否实施网络行动、是否会有欺骗行为。部署者问的是其应用是否安全:精心构造的文档、工具结果或用户消息,能否让应用泄露数据或执行不该执行的操作。两者的方法有所重叠,但问题和证据不同,第一个问题的合格结果并不能回答第二个问题。
Anthropic 描述了什么
与部署者实践重叠的方法
在 2024 年 6 月 12 日的一篇文章中,Anthropic 把其红队测试分为特定领域的专家测试、使用语言模型的测试、针对新模态的工作以及开放式方法。自动化红队测试采用红队与蓝队的对抗机制,由模型生成攻击。多模态红队测试在 Claude 3 模型部署前覆盖了图像和文本风险。多语言测试包括与新加坡资讯通信媒体发展局合作,覆盖四种语言:英语、泰米尔语、普通话和马来语。Anthropic 还提到了众包和社区红队测试,包括在 DEF CON 的 AI Village 举办的活动。[1]
日期为 2026 年 7 月 24 日的 Claude Opus 5 系统卡展示了同样的方法如何应用于一次发布。其防护措施章节使用了单轮的有害与无害请求、语境模糊的提示,以及由模拟用户逐步引向有害方向的多轮对话。它同时报告了无害性和过度拒绝,指出该模型在有害请求上保持了较高的无害回应率,同时在无害请求上的过度拒绝率处于最低之列。其智能体安全章节涵盖了对编程和计算机使用智能体的恶意利用,以及在编程、计算机使用和浏览器使用场景下的提示注入鲁棒性。[7]
系统卡把提示注入定义为隐藏在智能体所处理的工具结果中的恶意指令,并指出当智能体既能访问私密数据、又能代表用户采取行动时,风险最大。它还报告称,与没有系统提示词的 API 相比,claude.ai 系统提示词中的安全指令增强了模型对有害请求的处理能力。[7] 第二项发现与部署者直接相关,因为系统提示词属于部署者一方。
负责任扩展政策 3.4 版于 2026 年 7 月 8 日生效,它预先设定能力阈值,要求每六个月进行一次正式评估,并规定由外部审查者审阅风险报告。[4] 在测试之前固定阈值,可以减少事后重新解释结果的诱惑,这一做法适用于任何制定发布标准的组织。
只有模型开发者才能完成的工作
前沿威胁红队测试针对化学、生物、放射性和核(CBRN)风险、网络安全以及自主 AI 风险。一篇 2023 年的文章描述了拥有数十年经验的领域专家如何定义威胁模型、超过 100 小时的专家探查,以及一项历时六个月、超过 150 小时的生物安全研究。[3] 2025 年 3 月的一篇文章描述了基于夺旗挑战和模拟网络环境的网络能力评估,并指出前沿红队与美国 AI 安全研究所、英国 AI 安全研究所以及美国国家核安全管理局(NNSA)合作,其中与后者的合作涉及对核与放射性知识的机密评估。[2]
Anthropic 的透明度中心表示,公司同时采用内部和外部红队测试,英国 AI 安全研究所、美国 AI 标准与创新中心以及 Model Evaluation and Threat Research(METR)对其模型进行了额外测试。它还列出了在 HackerOne 上的漏洞赏金计划。[5] Opus 5 系统卡包含英国 AI 安全研究所的网络靶场测试、一项基于自动化行为审计的对齐评估,以及一个模型福祉章节。[7] 透明度中心页面没有说明某个模型在发布前由哪个机构测试,因此除系统卡所报告的内容外,本文无法确定各机构在部署前所扮演的角色。
外部测试和众包测试是一个单独的类别。据 HackerOne 报告,Anthropic 的越狱挑战于 2025 年 2 月 3 日至 10 日举行,有 339 名参与者,超过 300,000 次聊天交互,设有八个难度等级,四个团队共分得 55,000 美元赏金。成功的技术包括编码提示和密文、角色扮演、用无害关键词替换有害关键词,以及提示注入。[6] 对于 Opus 5,系统卡列出了三家签约的外部测试方:一家花费约 100 小时,借助针对特定任务的提示完成了一项任务;一家花费约 16 小时,未能成功越狱;还有一家运行自动化攻击程序,每项任务尝试 150 次,均未成功。[7]
仍由部署者负责的工作
上述开发者测试都不评估某个具体应用。以下事项仍由部署模型的组织负责,系统卡本身也指出了其中几项,例如它表明系统提示词会改变模型行为,以及智能体在把私密数据与行动能力结合起来时暴露程度最高。[7]
- 系统提示词及其护栏,包括它们在多轮压力下的表现。
- RAG 数据与间接提示注入:任何被检索进上下文的文档、网页或电子邮件都可能携带指令。
- 工具、智能体权限,以及被注入的指令可以借此做什么。
- 模型输出在到达浏览器、shell、数据库或人之前的下游处理。
- 供应链,包括第三方插件和 Model Context Protocol(MCP)服务器。
- 成本滥用,例如无限循环或消耗付费令牌的请求。
- 代码执行和浏览的沙箱化,以及对出站网络访问的控制。
- 日志、监控,以及决定某项变更何时可以发布的发布关卡。
值得借鉴的做法
- 在重大发布之前委托外部红队人员,或开展非公开的漏洞赏金计划。Anthropic 自己的做法两者兼有:每次发布都有签约的外部测试方,还有一项设有赏金的公开越狱挑战。
- 对智能体进行对齐式的行为检查:抽样查看工具使用记录,寻找绕过限制的尝试,正如 Anthropic 在内部部署中进行的监控那样。
- 为每次发布撰写一份简短的内部系统卡:测试了什么、哪些测试未通过、过度拒绝与有害性并列,以及已知的缺口。
- 参照负责任扩展政策的做法,在测试之前设定发布阈值。
- 通过智能体读取的每一个渠道测试提示注入,而不仅仅是用户输入。
FireAI University 关于 AI 安全框架与红队测试的课程更详细地介绍了这些方法。
与 FireAI 的关系
FireAI 在 Mac 上运行,位于任何模型之下。规则可以允许或拦截某个 App,或该 App 的某一个目的地,因此本地 AI 工具可以被限制在其所需的主机范围内。这样,一旦应用行为异常,数据可去的地方就受到限制。FireAI 不测试模型、不检测提示注入、不读取提示词,也不过滤模型输出。
局限
- 本文仅依据 Anthropic 和 HackerOne 已公开的内容。Anthropic 在此之外的内部流程不可见,而公开的摘要是有选择的。
- 资料来源的日期不同,从 2023 年 7 月到 2026 年 7 月,自较早的文章发表以来方法可能已经改变。
- 系统卡中描述的结果由开发者自行报告,归属于具名外部测试方的工作除外。
- 本文描述的是一家开发者。其他提供方公开的材料不同,而与部署者实践的比较是一种综合,并非来自资料来源的结论。
FireAI 和 HisnLabs 在其中扮演的角色
模型测试止于 API。App 或智能体可以从你的 Mac 访问哪里,是另一项控制,而 FireAI 提供的正是这项控制。
FireAI 是 HisnLabs 自己的产品:一款直接在 Mac 上运行的 AI 防火墙。它用通俗易懂的语言显示你的应用建立的每一个连接,并让你决定哪些数据可以离开你的 Mac——它的 AI 在本地运行,因此你的流量永远不会发送给我们或任何其他人。HisnLabs 的安全研究团队负责让这些判断保持准确:归类哪些域名只是普通的遥测、哪些属于真正的服务,追踪连接背后的国家和网络,并用真实的流量模式训练设备端模型(FireAI Pilot 功能)——这一切都不会离开你的 Mac。
你可以阅读它背后的技术决策,或试用 FireAI 17 天:HisnLabs 出品的 FireAI。