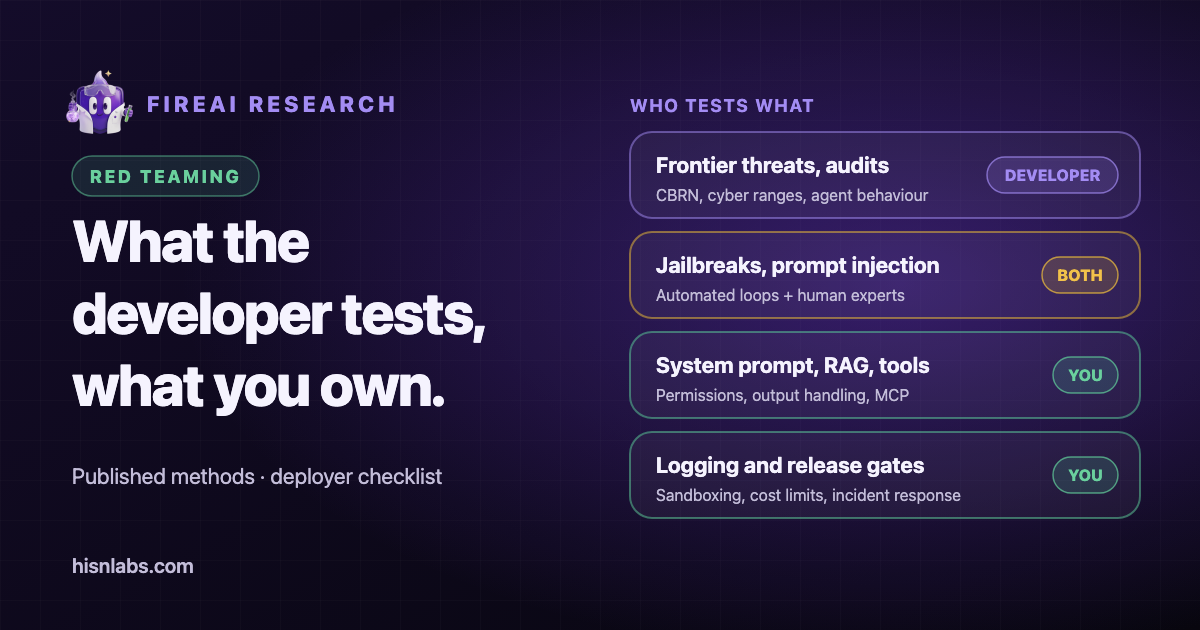
Anthropic, Claude’u nasıl test ettiği hakkında çoğu model geliştiricisinden daha fazlasını yayımlar: kırmızı takım çalışmasına dair blog yazıları, bir Responsible Scaling Policy ve her model için sistem kartları. Bu not, bu belgeleri özetler ve üç iş grubunu birbirinden ayırır: hem geliştiricilerin hem de uygulamayı devreye alanların kullandığı yöntemler, yalnızca bir geliştiricinin yapabileceği işler ve model üzerine bir uygulama kuran kuruluşa kalan işler. Anthropic’in yayımladıklarının ötesindeki iç süreçler dış okuyuculara görünmez ve burada anlatılmaz. Bu not, LLM’lerde paylaşılan sorumluluk: neyi kim güvence altına alır yazısıyla oluşturulan ikilinin ikinci yarısıdır.
Arka plan: iki farklı soru
Bir model geliştiricisi, bir modelin tehlikeli olup olmadığını sorar: silah geliştirmeye ciddi katkı sağlayıp sağlayamayacağını, siber operasyonlar yürütüp yürütemeyeceğini ya da aldatıcı davranıp davranamayacağını. Modeli devreye alan ise uygulamasının güvenli olup olmadığını sorar: özenle hazırlanmış bir belgenin, bir araç sonucunun ya da bir kullanıcı mesajının uygulamanın veri sızdırmasına veya yapmaması gereken bir eylemi gerçekleştirmesine yol açıp açamayacağını. Yöntemler örtüşür, ancak sorular ve kanıtlar farklıdır ve ilk sorudaki olumlu bir sonuç ikinci soruyu yanıtlamaz.
Anthropic’in anlattıkları
Devreye alanların pratiğiyle örtüşen yöntemler
Anthropic, 12 Haziran 2024 tarihli bir yazıda kırmızı takım çalışmasını alana özgü uzman testleri, dil modellerini kullanan testler, yeni modaliteler üzerindeki çalışmalar ve açık uçlu yaklaşımlar olarak gruplar. Otomatik kırmızı takım çalışması, saldırıları bir modelin ürettiği bir kırmızı takım-mavi takım dinamiği kullanır. Çok modlu kırmızı takım çalışması, Claude 3 modellerinde devreye almadan önce görüntü ve metin risklerini kapsamıştır. Çok dilli testler, Singapur’un Infocomm Media Development Authority kurumuyla dört dilde (İngilizce, Tamilce, Mandarin Çincesi ve Malayca) bir ortaklığı içermiştir. Anthropic ayrıca DEF CON’un AI Village etkinlikleri dahil kitle kaynaklı ve topluluk temelli kırmızı takım çalışmalarını da anar. [1]
24 Temmuz 2026 tarihli Claude Opus 5 sistem kartı, aynı yöntemlerin tek bir sürüme uygulanışını gösterir. Koruma önlemleri bölümünde tek turlu zararlı ve zararsız istekler, belirsiz bağlamlı istemler ve simüle edilmiş bir kullanıcının konuşmayı kademeli olarak zarara yönlendirdiği çok turlu konuşmalar kullanılır. Zararsızlığı aşırı reddetmeyle birlikte raporlar; modelin zararlı isteklerde yüksek zararsız yanıt oranlarını korurken zararsız isteklerde en düşük aşırı reddetme oranları arasında kaldığını belirtir. Ajan güvenliği bölümü, kodlama ve bilgisayar kullanımı ajanlarının kötüye kullanımını ve kodlama, bilgisayar kullanımı ve tarayıcı kullanımında istem enjeksiyonuna karşı dayanıklılığı kapsar. [7]
Sistem kartı istem enjeksiyonunu, bir ajanın işlediği araç sonuçlarına gizlenmiş kötü niyetli bir talimat olarak tanımlar ve riskin, bir ajan hem özel verilere erişebildiğinde hem de bir kullanıcı adına işlem yapabildiğinde en yüksek olduğunu not eder. Ayrıca claude.ai’deki sistem istemindeki güvenlik talimatlarının, sistem istemi olmayan API’ye kıyasla modelin zararlı istekleri ele alışını güçlendirdiğini bildirir. [7] İkinci bulgu doğrudan devreye alanları ilgilendirir, çünkü sistem istemi devreye alanın sorumluluk alanının parçasıdır.
8 Temmuz 2026’da yürürlüğe giren Responsible Scaling Policy 3.4 sürümü, yetenek eşiklerini önceden belirler, altı aylık aralıklarla resmî değerlendirmeler yapılmasını şart koşar ve risk raporlarının dış hakemlerce incelenmesini öngörür. [4] Eşikleri testten önce sabitlemek, bir sonucu sonradan yeniden yorumlama eğilimini sınırlar ve bu uygulama, yayın ölçütleri tanımlayan her kuruluşa aktarılabilir.
Yalnızca bir model geliştiricisinin yapabileceği işler
Öncü tehditlere yönelik kırmızı takım çalışması kimyasal, biyolojik, radyolojik ve nükleer (KBRN) riskleri, siber güvenliği ve otonom yapay zekâ risklerini hedefler. 2023 tarihli bir yazı, tehdit modellerini tanımlayan onlarca yıllık deneyime sahip alan uzmanlarını, 100 saati aşkın uzman yoklamasını ve 150 saati aşkın altı aylık bir biyogüvenlik çalışmasını anlatır. [3] Mart 2025 tarihli bir yazı, bayrak yakalama görevlerine ve simüle edilmiş ağ ortamlarına dayanan siber değerlendirmeleri anlatır ve Frontier Red Team’in ABD AI Safety Institute, Birleşik Krallık AI Security Institute ve ABD National Nuclear Security Administration (NNSA) ile çalıştığını, sonuncusuyla nükleer ve radyolojik bilgiye ilişkin gizli değerlendirmeler yürüttüğünü belirtir. [2]
Anthropic’in Transparency Hub sayfası, şirketin hem iç hem de dış kırmızı takım çalışması kullandığını ve Birleşik Krallık AI Security Institute, ABD Center for AI Standards and Innovation ile Model Evaluation and Threat Research’ün (METR) modellerine ek testler uyguladığını belirtir. Ayrıca HackerOne üzerindeki hata ödül programlarını listeler. [5] Opus 5 sistem kartı, Birleşik Krallık AI Security Institute’un siber poligon testlerini, otomatik bir davranış denetimine dayanan bir hizalama değerlendirmesini ve bir model refahı bölümünü içerir. [7] Transparency Hub sayfası belirli bir modeli yayından önce hangi kurumun test ettiğini belirtmez; bu nedenle her birinin devreye alma öncesindeki rolü, sistem kartının bildirdiklerinin ötesinde burada ortaya konmamıştır.
Dış ve kitle kaynaklı testler ayrı bir kategoridir. HackerOne, Anthropic’in jailbreak yarışmasının 3-10 Şubat 2025 tarihleri arasında 339 katılımcı, 300.000’i aşkın sohbet etkileşimi ve sekiz zorluk seviyesiyle yürütüldüğünü ve dört ekibin toplam 55.000 ABD dolarlık ödülü paylaştığını bildirir. Başarılı teknikler arasında kodlanmış istemler ve şifreler, rol yapma, zararlı anahtar sözcükleri zararsız olanlarla değiştirme ve istem enjeksiyonu vardı. [6] Opus 5 için sistem kartı, sözleşmeli üç dış test uzmanını anar: biri yaklaşık 100 saat harcamış ve göreve özgü istemlerle bir görevi tamamlamış, biri yaklaşık 16 saat harcamış ve başarılı bir jailbreak elde edememiş, biri de görev başına 150 denemeyle otomatik bir saldırgan çalıştırmış ve başarılı olamamıştır. [7]
Devreye alanlara kalanlar
Yukarıdaki geliştirici testlerinin hiçbiri belirli bir uygulamayı değerlendirmez. Aşağıdakiler modeli devreye alan kuruluşa kalır ve sistem kartının kendisi de bunların birçoğuna işaret eder; örneğin sistem istemlerinin model davranışını değiştirdiğini ve ajanların özel verileri işlem yapma yeteneğiyle birleştirdiklerinde en açık durumda olduklarını göstererek. [7]
- Sistem istemi ve korumaları; çok turlu baskı altında nasıl davrandıkları dahil.
- RAG verileri ve dolaylı istem enjeksiyonu: bağlama alınan her belge, sayfa ya da e-posta talimat taşıyabilir.
- Araçlar, ajan yetkileri ve enjekte edilmiş bir talimatın bunlarla neler yapabileceği.
- Model çıktısının bir tarayıcıya, kabuğa, veritabanına ya da bir kişiye ulaşmadan önce aşağı akışta işlenmesi.
- Üçüncü taraf eklentiler ve Model Context Protocol (MCP) sunucuları dahil tedarik zinciri.
- Sınırsız döngüler ya da ücretli belirteç tüketen istekler gibi maliyet istismarı.
- Kod çalıştırma ve web’de gezinmenin korumalı alanda yapılması ve giden ağ erişiminin denetimi.
- Bir değişikliğin ne zaman yayımlanabileceğine karar veren günlük kaydı, izleme ve yayın kapıları.
Ödünç alınmaya değer uygulamalar
- Büyük sürümlerden önce dış kırmızı takım uzmanlarıyla çalışın ya da özel bir hata ödül programı yürütün. Anthropic’in kendi pratiği ikisini de içerir: her sürüm için sözleşmeli dış test uzmanları ve ödüllü, herkese açık bir jailbreak yarışması.
- Ajanlar üzerinde hizalama tarzı bir davranış kontrolü yapın: Anthropic’in iç kullanım için yaptığı izlemede olduğu gibi araç kullanımı dökümlerinden örnekler alın ve kısıtlamaları aşma girişimlerini arayın.
- Her sürüm için kısa bir iç sistem kartı yazın: neyin test edildiği, hangi testlerin başarısız olduğu, zararın yanında aşırı reddetme ve bilinen eksikler.
- Responsible Scaling Policy yaklaşımını izleyerek yayın eşiklerini testten önce belirleyin.
- İstem enjeksiyonunu yalnızca kullanıcı girdisi üzerinden değil, bir ajanın okuduğu her kanal üzerinden test edin.
FireAI University’nin yapay zekâ güvenlik çerçeveleri ve kırmızı takım çalışması dersi bu yöntemleri daha ayrıntılı olarak ele alır.
FireAI ile ilgisi
FireAI, herhangi bir modelin altında, Mac üzerinde çalışır. Kurallar bir uygulamaya ya da o uygulama için tek bir hedefe izin verir veya engeller; böylece yerel bir yapay zekâ aracı ihtiyaç duyduğu ana makinelerle sınırlanabilir. Bu, bir uygulama yanlış davranırsa verilerin nereye gidebileceğini sınırlar. FireAI modelleri test etmez, istem enjeksiyonunu tespit etmez, istemleri okumaz ya da model çıktısını filtrelemez.
Sınırlılıklar
- Bu not yalnızca Anthropic’in ve HackerOne’ın yayımladıklarına dayanır. Anthropic’in bunun ötesindeki iç süreçleri görünür değildir ve yayımlanan özetler seçicidir.
- Kaynakların tarihleri Temmuz 2023 ile Temmuz 2026 arasında değişir ve yöntemler eski yazılardan bu yana değişmiş olabilir.
- Bir sistem kartında anlatılan sonuçlar, adı belirtilen dış test uzmanlarına atfedilen çalışmalar dışında, geliştiricinin kendi beyanıdır.
- Not tek bir geliştiriciyi anlatır. Diğer sağlayıcılar farklı materyaller yayımlar ve devreye alanların pratiğiyle karşılaştırma, kaynaklardan elde edilmiş bir bulgu değil, bir sentezdir.
FireAI ve HisnLabs burada nereye oturuyor
Model testi API’de sona erer. Bir uygulamanın ya da ajanın Mac’inizden nerelere ulaşabileceği ayrı bir denetimdir ve bunu FireAI sağlar.
FireAI, HisnLabs’in kendi ürünüdür: doğrudan Mac’inizde çalışan, yapay zekâ destekli bir güvenlik duvarı. Uygulamalarınızın kurduğu her bağlantıyı sade bir dille gösterir ve Mac’inizden neyin çıkacağına sizin karar vermenizi sağlar — yapay zekâsı yerel olarak çalışır, yani trafiğiniz asla bize ya da başka birine gönderilmez. HisnLabs güvenlik araştırma ekibi bu kararların isabetli kalmasını sağlayan ekiptir: hangi alan adlarının sıradan telemetri, hangilerinin gerçek bir hizmet olduğunu kataloglar, bir bağlantının ardındaki ülkeyi ve ağı izler ve cihaz üzerindeki modeli (FireAI Pilot özelliği) gerçek trafik örüntüleriyle eğitir — üstelik bunların hiçbiri Mac’inizden dışarı çıkmadan.
Arkasındaki teknik kararları okuyabilir ya da FireAI’yi 17 gün boyunca deneyebilirsiniz: HisnLabs’ten FireAI.