Organisationer som bygger på en värdbaserad språkmodell får en säkerhetstränad modell och en plattform från leverantören, men ansvarar fortfarande för applikationen runt den. Microsoft, Cloud Security Alliance och EU:s AI-förordning fördelar var och en arbetet mellan modelleverantören och den part som använder modellen, med olika terminologi och olika rättslig tyngd. Den här texten jämför de tre och beskriver en praktisk fördelning för det vanliga fallet där en modell används via ett API. Den kompletterar Så utför Anthropic red teaming av Claude, och vad som lämnas åt dig, som granskar leverantörens sida av gränsen i ett publicerat fall.
Bakgrund: molnmodellen utvidgad till AI
Modellen för delat ansvar i molnet tilldelar varje kontroll till leverantören eller kunden beroende på tjänstetyp: programvara som tjänst (SaaS), plattform som tjänst (PaaS) eller infrastruktur som tjänst (IaaS). Både Microsoft och Cloud Security Alliance (CSA) utvidgar den idén till generativ AI. Utvidgningen ändrar terminologin mer än logiken: ju längre ner i stacken en kund bygger, desto fler kontroller äger kunden.
Leverantörernas modeller
Microsoft: plattform, applikation och användning
Microsofts modell för delat ansvar för AI beskriver en AI-baserad applikation i tre lager: AI-plattformen, AI-applikationen och AI-användningen. Plattformslagret tillhandahåller modellen via API:er och innehåller ett säkerhetssystem som filtrerar skadliga indata och utdata. Applikationslagret är det gränssnitt användaren använder, med grundning, plugin-program och datakopplingar, och det behöver ett eget säkerhetssystem för applikationen. Användningslagret omfattar hur människor använder förmågan, och Microsoft hänvisar till identitets- och åtkomstkontroller, policyer för godtagbar användning och utbildning av användare. [1]
Hur stor del av varje lager kunden äger beror på distributionstypen. Sidan anger att ansvaret skiljer sig mellan SaaS, PaaS och IaaS, och rekommenderar att börja med SaaS-erbjudanden som Copilot, gå över till PaaS-tjänster som Azure OpenAI Service först när färdiga förmågor inte räcker till, och att reservera byggandet av egna modeller för organisationer med djup expertis. Sidan tillägger att vägledningen är illustrativ, används i styrningssyfte och inte ändrar något avtal med Microsoft. [1]
Microsoft: utvidgningen till agenter
En andra sida från Microsoft behandlar agenter, som den skiljer från en ren modell eftersom en agent agerar utan att en människa godkänner varje steg, planerar och itererar, har ett minne, har en egen identitet och kan kombineras med andra agenter. Den lägger till tre lager: orkestrering av agenter, verktyg och åtgärder samt minne och tillstånd. I dess ansvarsmatris behåller kunden i PaaS-fallet agentens instruktioner och omfattning, behörigheter per verktyg och mänskligt godkännande av åtgärder med stor påverkan, medan körmiljön och orkestreringsplattformen tillhör Microsoft. [2]
Sidan listar ansvar som kunden alltid behåller: data, identitet och minsta behörighet, auktorisering av åtgärder, mänsklig tillsyn samt godtagbar användning och styrning. Den anger också att autonomi aldrig minskar ansvarsskyldigheten. [2]
Cloud Security Alliance: ett förslag från 2023
I ett blogginlägg daterat den 28 juli 2023 föreslog en CSA-fellow en modell med tre parter: leverantören av AI-tjänsten, användaren av AI-tjänsten som bygger en applikation, och företaget eller slutanvändaren av den applikationen. Enligt förslaget tillhandahåller en IaaS-leverantör infrastruktur och grundmodeller, medan användaren ansvarar för träning, datavalidering, promptfiltrering och applikationssäkerhet; i PaaS-fallet står användaren för kontext och applikationssäkerhet; i SaaS-fallet hanterar användaren grundning, promptfiltrering och skydd av immateriella rättigheter. Inlägget presenterar detta som ett förslag som fördelar uppgifter, inte som en standard. [3]
Lagstiftning: EU:s AI-förordning fördelar skyldigheter efter roll
EU:s AI-förordning tilldelar skyldigheter efter roll. Enligt Europeiska kommissionens vanliga frågor om riktlinjerna är en leverantör av en AI-modell för allmänna ändamål den enhet som utvecklar modellen, eller låter utveckla den, och släpper ut den på marknaden under eget namn. Leverantörens skyldigheter omfattar teknisk dokumentation, dokumentation för nedströmsutvecklare om förmågor och begränsningar, en policy för efterlevnad av upphovsrätt och en offentlig sammanfattning av träningsinnehållet. Dessa skyldigheter gäller sedan den 2 augusti 2025. Modeller som antas medföra systemrisk, vid eller över 10^25 flyttalsoperationer i träningsberäkning, har ytterligare skyldigheter, bland annat antagonistisk testning och cybersäkerhetsskydd. [4]
Samma vanliga frågor anger den 2 augusti 2026 som det datum från vilket tillsyn, inklusive sanktionsavgifter, gäller för dessa leverantörer, och den 2 augusti 2027 som tidsfrist för modeller som släppts ut på marknaden före den 2 augusti 2025. Där anges också att en nedströmsutvecklare som modifierar en modell blir leverantör endast under exceptionella omständigheter, till exempel om mer än en tredjedel av den ursprungliga träningsberäkningen används, så att de flesta finjusteringar inte flyttar leverantörsrollen. [4]
Tillhandahållare, det vill säga organisationer som använder AI-system, har en separat uppsättning skyldigheter. En analys från en advokatbyrå daterad den 24 juli 2026 listar upplysning om deepfakes och information till enskilda om känsloigenkänning och biometrisk kategorisering som skyldigheter för tillhandahållare från den 2 augusti 2026. För högrisksystem listar den kompetent mänsklig tillsyn, information till enskilda om att AI används och samråd med arbetstagare. [6] Kommissionens sida med tidslinjen tillägger att tillhandahållare måste säkerställa mänsklig tillsyn och övervakning och rapportera allvarliga incidenter när systemen har släppts ut på marknaden. [5]
Uppskjutandet genom Digital Omnibus
Tidsfristerna för högrisksystem har flyttats. Kommissionens sida med tidslinjen anger den 2 december 2027 för högrisksystem inom känsliga områden som biometri, anställning och brottsbekämpning, och den 2 augusti 2028 för högrisksystem som ingår i reglerade produkter, och hänvisar till Digital Omnibus om AI, som den beskriver som att träda i kraft i juli 2026. [5] Analysen från Norton Rose Fulbright anger samma två datum och uppger att Omnibus har publicerats i EU:s författningssamling. [6] Två oberoende källor är alltså överens om att uppskjutandet har antagits och inte bara föreslagits. Leverantörers skyldigheter för modeller för allmänna ändamål och transparensskyldigheterna ovan flyttas inte av dessa två datum.
Fördelning av arbetet när en modell används via ett API
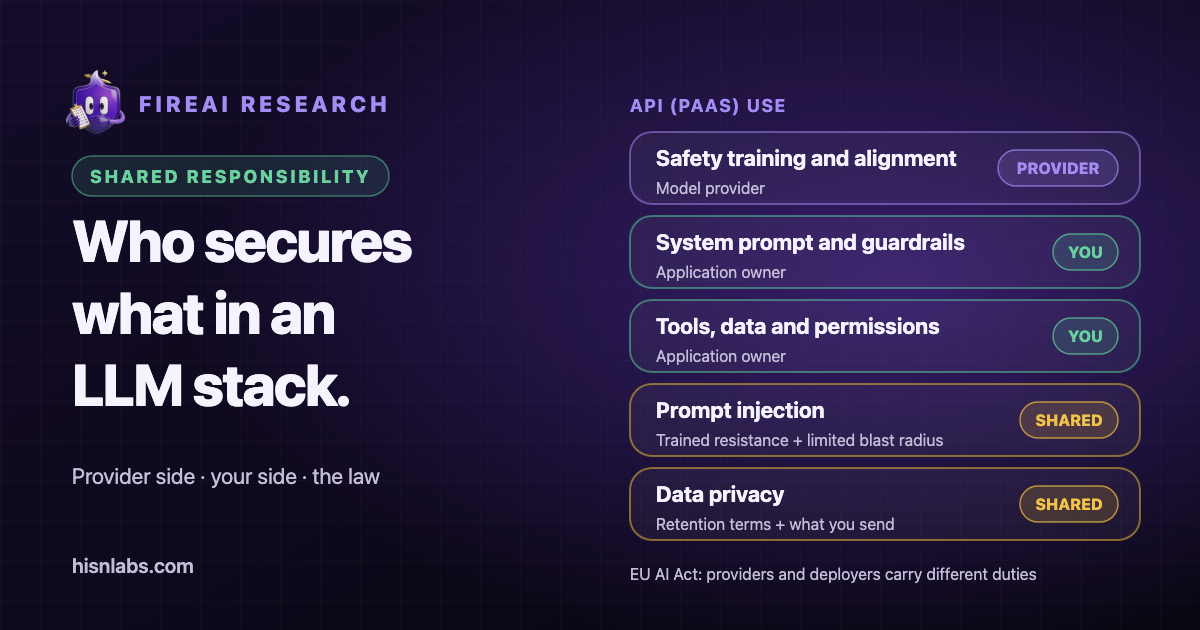
För PaaS-fallet, där en applikation anropar en värdbaserad modell, stöder källorna följande fördelning. Raderna från Microsoft följer de plattforms- och applikationslager som beskrivs ovan; raderna om testning av risker för frontiermodeller, systemdokumentation och kanaler för rapportering av sårbarheter återspeglar leverantörsskyldigheterna i EU:s riktlinjer och de rutiner som modelleverantörer publicerar. Tabellen är en sammanställning gjord av FireAI, inte en text från någon av källorna.
| Område | Leverantörens sida | Din sida |
|---|---|---|
| Modellens beteende | Säkerhetsträning och anpassning av modellen | Systemprompt och skyddsräcken i applikationen |
| Risktestning | Testning av risker för frontiermodeller i själva modellen | Testning av din applikation, inklusive dess prompter, data och verktyg |
| Plattform | Plattformssäkerhet och grundläggande filter för indata och utdata | Säkerhetskontroller i applikationen för innehåll, plugin-program och kopplingar |
| Dokumentation | Systemkort och dokumentation för nedströmsutvecklare | Att läsa den och registrera vilken modell och version du har driftsatt |
| Data och verktyg | Inget utöver API-avtalet | RAG-data, verktyg, agenter och deras behörigheter |
| Utdata | Returnerar genererad text | Hantering av utdata nedströms: validering, escapning, mänskligt godkännande |
| Drift | Kanal för rapportering av sårbarheter i modellen | Loggning, övervakning och incidenthantering för applikationen |
| Människor | Villkor i användningspolicyn | Din egen användningspolicy och utbildning av användare |
Två områden är delade i strikt mening. Det första är promptinjektion: leverantören tränar modellen att stå emot injicerade instruktioner, och tillhandahållaren begränsar vad en injicerad instruktion kan åstadkomma genom verktygsbehörigheter och dataåtkomst. Microsofts sida om agenter beskriver samma uppdelning och uppmanar kunder att behandla hämtat innehåll, utdata från verktyg och andra agenters meddelanden som obetrodda och att kontrollera åtgärder med stor påverkan. [2] Det andra är dataskydd: leverantören fastställer villkor för lagring och träning, och tillhandahållaren avgör vilka data som över huvud taget hamnar i en prompt eller ett sökindex.
Rekommendationer
- Identifiera först distributionstypen (SaaS, PaaS eller egen drift) och skriv ner vilka rader i fördelningen ovan som organisationen äger.
- Testa tillhandahållarens sida direkt: systemprompten, hämtningsdata, verktygsbehörigheter och hantering av utdata. Leverantörens testning av modellen omfattar inte dessa.
- Innan du börjar använda en modell, läs leverantörens systemkort och dess villkor för datalagring och träning, och ta reda på dess kanal för rapportering av sårbarheter.
- Begränsa vad en injicerad instruktion kan göra: verktyg med minsta behörighet, avgränsad dataåtkomst och mänskligt godkännande för oåterkalleliga åtgärder.
- Bestäm vilka data som får hamna i prompter, och spara loggar som räcker för att rekonstruera en incident.
- För utbildningsmaterial om ramverk och red teaming, se FireAI Universitys kurs om ramverk för AI-säkerhet och red teaming.
Relevans för FireAI
En lokal app eller agent som anropar ett modell-API är en app på Macen, och dess destinationer är synliga för FireAI. Aktivitet listar vilka appar som gick ut på nätet, och Regler låter en användare tillåta eller blockera en app eller en specifik destination. Det är en kontroll på tillhandahållarens sida, på en enskild Mac. FireAI granskar inte prompter, bedömer inte modellens utdata, upptäcker inte promptinjektion och bedömer inte om en leverantör uppfyller någon rättslig skyldighet.
Begränsningar
- Microsofts sidor är leverantörsvägledning för Azure-produkter, beskriver sig själva som illustrativa och ändrar inte avtalsvillkor. CSA-texten är ett förslag från 2023.
- Den här texten är inte juridisk rådgivning. Huruvida en organisation är leverantör, tillhandahållare eller operatör av högrisksystem enligt EU:s AI-förordning beror på omständigheter som den här texten inte bedömer, och nationella myndigheter kan tolka förordningen olika.
- Datumen för Digital Omnibus kommer från kommissionens sida med tidslinjen och en analys från en advokatbyrå. Själva förordningstexten har inte granskats för den här texten.
- API-tabellen är en sammanställning, och enskilda leverantörer placerar vissa rader annorlunda i sina villkor.
Var FireAI och HisnLabs kommer in
Din sida av gränsen omfattar det som lämnar Macen. FireAI visar det och låter dig bestämma.
FireAI är HisnLabs eget verktyg: en AI-brandvägg som körs direkt på din Mac. Den visar varje anslutning dina appar gör, på klarspråk, och låter dig avgöra vad som lämnar din Mac — AI:n körs lokalt, så din trafik skickas aldrig till oss eller någon annan. HisnLabs säkerhetsforskningsteam är de som håller de bedömningarna tillförlitliga: de katalogiserar vilka domäner som är vanlig telemetri och vilka som är en riktig tjänst, spårar land och nätverk bakom en anslutning och tränar den lokala modellen (FireAI Pilot-funktionen) på verkliga trafikmönster — utan att något av det lämnar din Mac.
Du kan läsa om de tekniska besluten bakom, eller prova FireAI i 17 dagar, på FireAI, från HisnLabs.