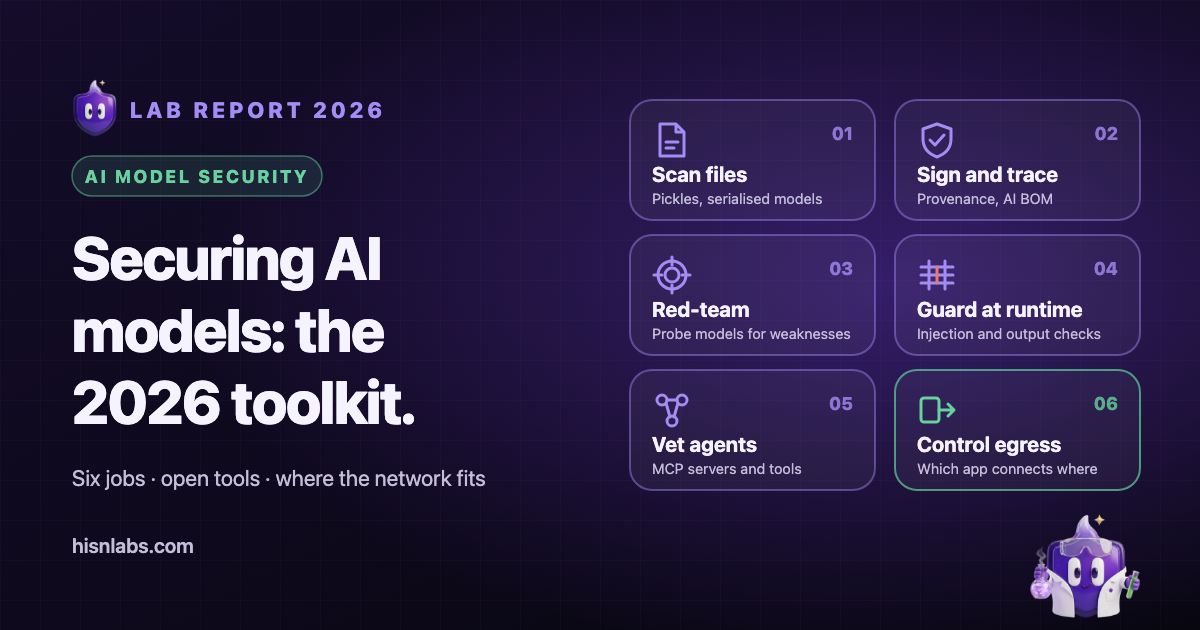
Säkerhet i AI-modeller är inte en disciplin utan sex uppgifter, var och en med egna verktyg: att skanna modellfiler, fastställa ursprung, undersöka en modell efter svagheter, skydda den under körning, granska agentverktygen runt den och begränsa vart den värdande applikationen kan ansluta. Den här översikten, sammanställd av HisnLabs, utvecklaren av FireAI, omfattar öppna verktyg vars arkiv eller dokumentation lästes den 30 september 2026. Licenser, förvaltare och status anges så som primärkällorna anger dem, och inget verktyg rangordnas över något annat, eftersom uppgifterna inte konkurrerar med varandra.
Omfattning och metod
Ett verktyg togs med endast om dess officiella arkiv eller dokumentation gick att öppna, dess licens kunde fastställas och dess underhållsstatus kunde kontrolleras (arkiverat eller aktivt, samt datum för den senaste utgåvan där utgåvesidan visar ett). De utgåvor som nämns nedan är de senaste vid läsningstillfället. Inget här är en prestandamätning: källorna ger inga jämförbara detektionsresultat, och inga sådana påstås. Kommersiella plattformar utelämnas om inte en öppen komponent är föremålet.
Kategorierna följer den ordning i vilken en modell rör sig genom ett projekt: en fil laddas ner, dess ursprung kontrolleras, modellen testas, den driftsätts bakom skydd, den kopplas till verktyg och applikationen som kör den når nätverket. OWASP Top 10 for Large Language Model Applications, som förvaltas inom OWASP GenAI Security Project, är det vanliga gemensamma begreppsförrådet för riskerna på applikationsnivå i kategori tre till fem.
1. Skanning av modellfiler
Många modellfiler serialiseras med Pythons pickle-format, som kan köra kod när filen laddas. Hugging Faces dokumentation anger att inläsning av en pickle ”innebär att kod kan köras” och nämner opkoderna GLOBAL, STACK_GLOBAL och REDUCE som de som utgör hotet. Hugging Face: Pickle scanning Skannrar läser filens instruktioner utan att ladda den och flaggar farliga importer.
ModelScan
ModelScan förvaltas av Protect AI under licensen Apache-2.0. Det skannar pickle-baserade format (PyTorch, scikit-learn, XGBoost, joblib, cloudpickle), TensorFlow SavedModel samt Keras H5- och V3-filer, rangordnar fynd efter allvarlighetsgrad och avslutar med returkoder anpassade för CI-flöden. Den senaste utgåvan på sidan är v0.8.8 från 18 februari 2026, och arkivet visade aktivitet den 28 september 2026. Använd det som en spärr innan en nedladdad modell kommer in i ett bygge. Begränsning: README-filen beskriver signaturbaserad detektion som kan ge falska positiva och falska negativa, och fynden behöver granskas av en människa.
picklescan
picklescan är en MIT-licensierad skanner som förvaltas av ett enskilt konto, mmaitre314. Hugging Faces dokumentation nämner picklescan bland de verktyg som utvecklats för Hub. Den senaste utgåvan är v1.0.5 från 1 juli 2026. Den skannar pickle-filer, PyTorch-arkiv och ZIP-behållare, och kan skanna en lokal sökväg, en URL eller en modell på Hugging Face. Använd den för en snabb kontroll i ett skript. Begränsning: den matchar farliga operationer mot mönster, så en ny teknik kan slinka igenom, och den rapporterar fynd utan att ta bort dem.
fickling
fickling, från Trail of Bits, är licensierat under LGPL-3.0. Det beskrivs som en dekompilator, statisk analysator och bytekodsomskrivare för pickle. Det kan dekompilera en pickle till läsbar Python, kontrollera säkerheten genom statisk analys och avbryta med ett fel innan en osäker fil laddas. Den senaste utgåvan är v0.1.12 från 26 juni 2026. Använd det när ett fynd måste förstås, inte bara flaggas. Begränsning: det är ett analysverktyg för pickle och täcker inte de övriga format som ModelScan läser. Licensvillkoren skiljer sig från de tillåtande licenserna för de andra skannrarna.
Skanning på Hugging Face Hub och safetensors
Hub skannar varje uppladdad fil med ClamAV och med en importskanning för pickle som listar importerna i varje picklad fil och markerar misstänkta. Hugging Face: file scanning Den visar även resultat från en tredjepartsskanner, Protect AI:s Guardian, för offentliga arkiv. Hugging Face: Protect AI Begränsning, så som Hugging Face formulerar den: pickle-skanningen är inte helt idiotsäker, dess listor underhålls efter bästa förmåga och det är användarens ansvar att kontrollera vad som är säkert. Det strukturella alternativet är safetensors, ett Apache-2.0-format som förvaltas av Hugging Face och lagrar tensorer utan körbart innehåll. Det eliminerar pickle-risken för vikter men säger inget om huruvida vikterna själva är pålitliga.
2. Modellursprung, signering och fingeravtryck
Skanning frågar om en fil är farlig att ladda. Ursprungskontroll frågar vem som har tagit fram den och om den har ändrats sedan dess. De två frågorna kräver olika verktyg.
Sigstore model-transparency
model-transparency är ett Apache-2.0-projekt inom Sigstore-organisationen som signerar och verifierar maskininlärningsmodeller. Det kan signera via Sigstore, eller med nycklar, certifikat eller PKCS #11-enheter, och skapar ett paket som innehåller ett DSSE-kuvert med ett in-toto-utlåtande. Den senaste utgåvan är v1.1.1 från 10 oktober 2025, med incheckningar i september 2026. Använd det för att låta en mottagare verifiera att filerna de har är de som en utgivare signerade. Begränsningar: dokumentationen anger stöd för hashning av filer och filfragment, inte enskilda tensorer, och en giltig signatur bevisar ursprung och integritet, inte att modellen är säker. Hugging Face gör samma åtskillnad för signerade incheckningar, som garanterar ”filens ursprung” och inte att den är säker.
Materialförteckningar för AI och ML
CycloneDX, som förvaltas av OWASP Foundation och Ecma Internationals TC54, listar en Machine Learning Bill of Materials (ML-BOM) bland de BOM-typer som stöds. Den senaste utgåvan, 1.7, publicerades den 21 oktober 2025, och scheman är licensierade under Apache-2.0. SPDX 3.0 AI profile dokumenterar AI-komponenter som modeller, datamängder och promptar i en sammanhängande post. Använd endera för att föra en förteckning över vilka modeller, datamängder och versioner en produkt innehåller, vilket är det en incidenthantering behöver först. Begränsning: en BOM registrerar vad en upphovsperson uppger. Inget av formaten verifierar uppgiften.
Forskningsverktyg för fingeravtryck och vattenmärkning
Instructional Fingerprinting är koden till en vetenskaplig artikel (arXiv 2401.12255) som bäddar in ett fingeravtryck i en språkmodell så att en ägare senare kan testa om en annan modell härstammar från den. Det är MIT-licensierad forskningskod, och arkivet uppdaterades senast i juli 2024. MarkLLM, från gruppen THU-BPM, är en Apache-2.0-verktygslåda för vattenmärkning av text som en LLM genererar, presenterad som en demo vid EMNLP 2024. De två besvarar olika frågor: den första märker en modell, den andra märker dess utdata. Använd dem för att studera attribuering, inte som en produktionskontroll. Begränsning: båda är forskningsartefakter, och ingen av dem ersätter signering av en distribuerad fil.
3. Red teaming och sårbarhetsskanning av LLM
Dessa verktyg skickar adversariella indata till en modell eller applikation och registrerar hur den svarar. De testar beteende, inte filer.
garak
garak är en Apache-2.0-licensierad sårbarhetsskanner för LLM som förvaltas av NVIDIA. Enligt README-filen kontrollerar den ”om en LLM kan fås att fallera på ett sätt vi inte vill”, med sonder för promptinjektion, dataläckage, hallucinationer, toxicitet och jailbreaks, var och en parad med en detektor. Den senaste utgåvan är v0.17.0 från 9 september 2026. Använd den som en bred grundskanning av en modells slutpunkt. Begränsningar: den kräver API-åtkomst eller en lokal driftsättning av målet, vissa sonder är resurskrävande, och README-filen noterar begränsat stöd för bildmodeller och prototypstatus för vissa sonder.
PyRIT
PyRIT är ett MIT-licensierat ramverk som beskrivs som byggt för säkerhetsexperter och ingenjörer för att identifiera risker i generativa AI-system. Det förvaltas av Microsoft, och den senaste utgåvan är v1.1.0 från 4 september 2026. Det tidigare arkivet under Azure-organisationen arkiverades den 27 mars 2026 med en hänvisning till Microsofts arkiv, så länkar till den gamla adressen leder till en skrivskyddad kopia. Använd det för skriptade red team-kampanjer med flera turer, av ett team som kommer att skriva kod. Begränsning: det är ett ramverk, inte en skanner som körs med ett enda kommando.
promptfoo
promptfoo är ett MIT-licensierat kommandoradsverktyg och bibliotek för att utvärdera LLM-applikationer och för red teaming och sårbarhetsskanning, med CI-integration. Den senaste utgåvan är 0.123.1 från 18 september 2026. README-filen anger: ”Promptfoo is now part of OpenAI. Promptfoo remains open source and MIT licensed.” Använd det för att lägga in prompttester och adversariella kontroller i ett bygge. Begränsning: resultaten beror på vilken leverantör och vilken bedömare som har konfigurerats, och de flesta leverantörer kräver API-nycklar. Ägarbytet är ett styrningsfaktum värt att notera vid val av verktyg för reglerad verksamhet.
Giskard
Giskard är ett Apache-2.0-licensierat Python-bibliotek från organisationen Giskard-AI. Version 3 har två komponenter som beskrivs som stabila: giskard-checks, ett testramverk som använder scenarier och bedömningar med LLM som domare, och giskard-scan, en skanner för sårbarheter i agenter. Använd det för att testa agentsystem och system med hämtningsförstärkt generering. Begränsningar: version 3 kräver Python 3.12 eller senare, och version 2, som omfattade skanning av tabelldata och klassisk maskininlärning, underhålls inte längre aktivt.
4. Skydd under körning och detektion av promptinjektion
Skydd under körning ligger i anropsvägen och klassificerar eller begränsar indata och utdata medan applikationen körs.
Llama Guard, Prompt Guard och LlamaFirewall
Metas projekt Purple Llama samlar skyddsmekanismer för öppna modeller. Llama Guard är en familj av modeller för moderering av indata och utdata. Prompt Guard 2 beskrivs som en lättviktig klassificerare för direkta försök till promptinjektion, och LlamaFirewall kombinerar den med en skanner för kontroll av alignment och en kodskanner för agenter. Enligt projektets licenstabell distribueras modellerna under Llama Community Licences, och andra komponenter, som Code Shield och utvärderingarna, under MIT. Modellerna på Hugging Face kräver godkänd åtkomst. Använd dem där en liten klassificerare framför en modell är acceptabel. Begränsningar: en klassificerare minskar försök som liknar kända mönster men eliminerar inte angreppsklassen.
NeMo Guardrails
NeMo Guardrails är en Apache-2.0-verktygslåda från NVIDIA för att lägga till programmerbara skyddsräcken i LLM-applikationer, med ett modelleringsspråk kallat Colang för att styra dialogflödet. Den senaste utgåvan är v0.24.1 från 16 september 2026. Använd den för att begränsa ämnen, format och dialogvägar. Begränsning: skyddsräckena är policy skriven av utvecklaren, så deras täckning är bara så bred som det som förutsågs.
Rebuff och LLM Guard, nu arkiverade
Rebuff, en självhärdande detektor för promptinjektion med heuristik, en LLM-kontroll, en vektordatabas över tidigare angrepp och kanariefågeltoken, arkiverades den 16 maj 2025. Dess README-fil anger att det är en prototyp som inte kan ge fullständigt skydd mot promptinjektion. LLM Guard, en MIT-licensierad verktygslåda med skannrar för indata och utdata från samma förvaltare, arkiverades i juli 2026. Båda går fortfarande att läsa som referens. De illustrerar en praktisk poäng: detektorprojekt kan förlora sina förvaltare, så ett skydd bör gå att byta ut.
5. Säkerhetsskannrar för agenter och MCP
Agenter lägger till verktyg, och verktygsbeskrivningar är text som modellen läser. Skannrarna i denna grupp granskar dessa verktyg och deras konfiguration.
Snyk Agent Scan
Agent Scan, tidigare MCP-Scan, är en Apache-2.0-licensierad skanner som förvaltas av Snyk. Den hittar agentkomponenter på en dator, inklusive MCP-servrar och skills i klienter som Claude, Cursor, VS Code och GitHub Copilot, och kontrollerar dem efter promptinjektion, verktygsförgiftning och närliggande problem. Den senaste utgåvan är v0.6.8 från 29 september 2026. Använd den för att granska vad en utvecklardator har installerat. Begränsningar: README-filen anger att projektet för närvarande inte tar emot externa bidrag, och att det finns två utgåvelinjer med olika utdataformat.
Cisco MCP Scanner
MCP Scanner är ett Apache-2.0-verktyg från Cisco AI Defense. Det analyserar MCP-verktyg, promptar, resurser och beroenden med tre motorer som kan köras var för sig eller tillsammans: YARA-regler, LLM-analys och Cisco AI Defense API. Den senaste utgåvan är 4.8.4 från 28 augusti 2026. Använd det för att kontrollera en server innan den tas i bruk. Begränsning: LLM- och API-motorerna kräver externa inloggningsuppgifter, och en skanning av en servers beskrivning säger lite om vad dess kod gör efter en uppdatering.
6. Var nätverkskontroller passar in
Verktygen ovan granskar filer, modeller, promptar och konfigurationer. Inget av dem avgör vilken applikation som får öppna en anslutning till vilken server. Det är uppgiften för utgående trafikkontroll, och den har betydelse eftersom riskerna i de föregående avsnitten möts i nätverket: en manipulerad modellmiljö, ett förgiftat verktyg eller en injicerad agent måste nå en destination för att föra ut data eller ta emot instruktioner.
FireAI, som utvecklas av HisnLabs, är en brandvägg för utgående trafik på macOS. Den körs som ett innehållsfilter i Apples Network Extension, identifierar varje app på dess kodsignatur och kan tillåta, blockera eller fråga för varje destination, med regler per app, domän eller adress. Tillämpat på AI-arbete på en Mac innebär det att en inferensserver, en kodagent eller en MCP-klient kan hållas till de destinationer dess uppgift kräver, och att en ny destination utlöser ett beslut. Dokumentationen om filtret beskriver vad FireAI ser: appens identitet, fjärrvärd eller adress, port och protokoll.
FireAI skannar inte modellfiler, verifierar inte signaturer, utför inte red teaming mot modeller och klassificerar inte promptar. Den läser inte innehållet i krypterade anslutningar, så den kan inte skilja ett legitimt anrop från ett injicerat när båda går till en tillåten destination. Den kompletterar verktygen ovan och ersätter inget av dem.
Jämförelse
| Verktyg | Uppgift | Förvaltare | Licens | Status den 30 sep 2026 |
|---|---|---|---|---|
| ModelScan | Skanning av modellfiler | Protect AI | Apache-2.0 | Aktivt, v0.8.8 |
| picklescan | Skanning av pickle | mmaitre314 | MIT | Aktivt, v1.0.5 |
| fickling | Analys av pickle | Trail of Bits | LGPL-3.0 | Aktivt, v0.1.12 |
| safetensors | Säkert viktformat | Hugging Face | Apache-2.0 | Aktivt |
| model-transparency | Modellsignering | Sigstore | Apache-2.0 | Aktivt, v1.1.1 |
| CycloneDX | ML-BOM-specifikation | OWASP, Ecma TC54 | Apache-2.0 (scheman) | Aktivt, 1.7 |
| Instructional Fingerprinting | Modellfingeravtryck (forskning) | Artikelns författare | MIT | Senast uppdaterat juli 2024 |
| MarkLLM | Vattenmärkning av text (forskning) | THU-BPM | Apache-2.0 | Aktivt |
| garak | Sårbarhetsskanning | NVIDIA | Apache-2.0 | Aktivt, v0.17.0 |
| PyRIT | Ramverk för red teaming | Microsoft | MIT | Aktivt, v1.1.0 |
| promptfoo | Utvärdering och red teaming | Promptfoo, del av OpenAI | MIT | Aktivt, 0.123.1 |
| Giskard v3 | Agenttester och skanning | Giskard-AI | Apache-2.0 | Aktivt; v2 underhålls inte |
| Llama Guard, Prompt Guard | Skyddsmodeller | Meta | Llama Community Licences | Modeller daterade april 2025 |
| NeMo Guardrails | Programmerbara skyddsräcken | NVIDIA | Apache-2.0 | Aktivt, v0.24.1 |
| Rebuff, LLM Guard | Detektion av injektion | Protect AI | Apache-2.0, MIT | Arkiverade |
| Agent Scan | Skanning av agenter och MCP | Snyk | Apache-2.0 | Aktivt, v0.6.8 |
| MCP Scanner | Skanning av MCP-servrar | Cisco AI Defense | Apache-2.0 | Aktivt, 4.8.4 |
| FireAI | Kontroll av utgående trafik per app på macOS | HisnLabs | Kommersiell | Skannar inte modeller |
Begränsningar
- Inget enskilt verktyg täcker alla sex uppgifter. En ren filskanning säger inget om en modells beteende, en signatur säger inget om säkerhet och en red team-skanning säger inget om en fils innehåll.
- Skannrar och skydd är detektorer. De kan missa nya tekniker, vilket dokumentationen för ModelScan, picklescan och Rebuff var för sig medger, och deras täckning förändras när angreppen förändras.
- Underhållet är ojämnt. Två av de detektorprojekt som listas här är arkiverade, ett verktyg har bytt ägare, ett har en enskild förvaltare och ett forskningsarkiv har inte ändrats sedan 2024. Kontrollera ett projekts status innan du bygger på det.
- Översikten begränsades till öppna verktyg med primärkällor som gick att läsa. Den utesluter kommersiella plattformar och jämför inte detektionsresultat, eftersom källorna inte ger några jämförbara siffror.
- Licenserna lästes från arkivsidor och licenstabeller. Verifiera dem före vidaredistribution, i synnerhet Llama Community Licences och LGPL-villkoren för fickling.
- Nätverkslagret ser anslutningar, inte innebörd. En tillåten destination kan fortfarande ta emot data från en komprometterad modellmiljö.
Var FireAI och HisnLabs kommer in
Skanna modellen, signera modellen, testa modellen. Bestäm sedan vart dess app får ansluta.
FireAI är HisnLabs eget verktyg: en AI-brandvägg som körs direkt på din Mac. Den visar varje anslutning dina appar gör, på klarspråk, och låter dig avgöra vad som lämnar din Mac — AI:n körs lokalt, så din trafik skickas aldrig till oss eller någon annan. HisnLabs säkerhetsforskningsteam är de som håller de bedömningarna tillförlitliga: de katalogiserar vilka domäner som är vanlig telemetri och vilka som är en riktig tjänst, spårar land och nätverk bakom en anslutning och tränar den lokala modellen (FireAI Pilot-funktionen) på verkliga trafikmönster — utan att något av det lämnar din Mac.
Du kan läsa om de tekniska besluten bakom, eller prova FireAI i 17 dagar, på FireAI, från HisnLabs.