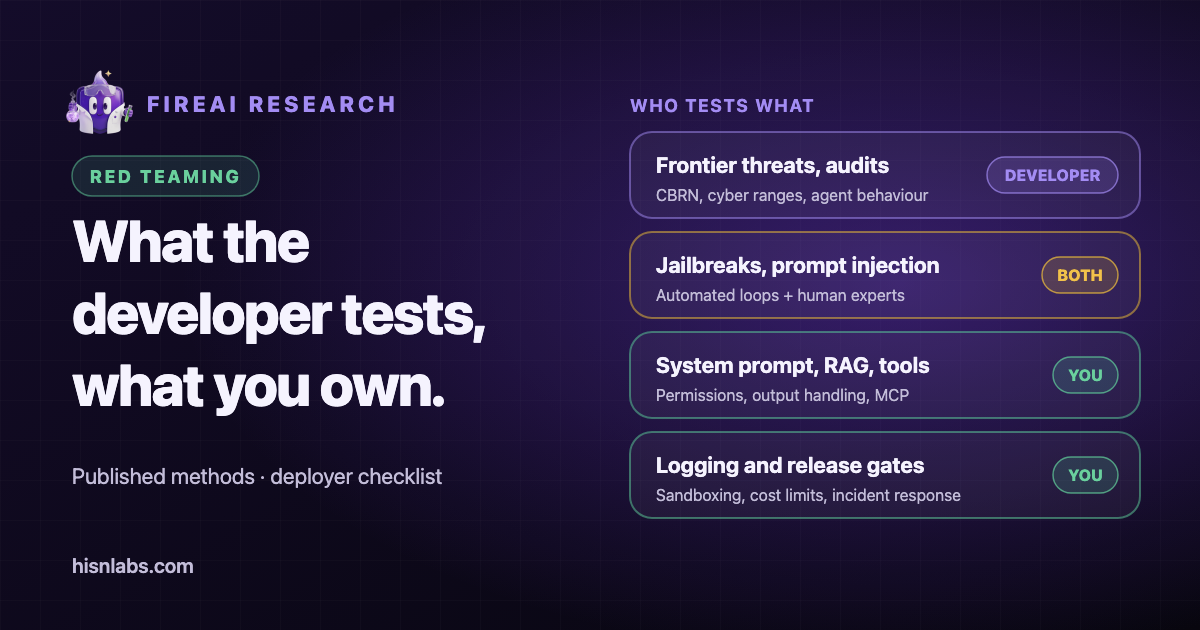
Anthropic публикует о тестировании Claude больше, чем большинство разработчиков моделей: статьи о red teaming, Responsible Scaling Policy и системные карты (system cards) для каждой модели. В этой заметке кратко изложены эти документы и выделены три группы работ: методы, которые применяют и разработчики моделей, и те, кто внедряет их в свои продукты; работа, которую может выполнить только разработчик модели; и работа, которая остаётся за организацией, строящей приложение на основе модели. Внутренние процессы, выходящие за рамки опубликованного Anthropic, внешнему читателю не видны и здесь не описываются. Заметка составляет вторую часть пары с материалом Shared responsibility for LLMs: who secures what.
Контекст: два разных вопроса
Разработчик модели спрашивает, опасна ли модель: может ли она существенно помочь в создании оружия, проводить кибероперации или вести себя обманчиво. Тот, кто внедряет модель, спрашивает, безопасно ли его приложение: может ли специально составленный документ, результат инструмента или сообщение пользователя заставить приложение раскрыть данные или выполнить действие, которого оно выполнять не должно. Методы пересекаются, но вопросы и доказательства различаются, и положительный ответ на первый вопрос не отвечает на второй.
Что описывает Anthropic
Методы, совпадающие с практикой внедряющих организаций
В публикации от 12 июня 2024 года Anthropic разделяет свой red teaming на экспертное тестирование в отдельных предметных областях, тестирование с помощью языковых моделей, работу с новыми модальностями и открытые подходы. Автоматизированный red teaming строится на взаимодействии red team и blue team, в котором атаки генерирует модель. Мультимодальный red teaming до выпуска охватывал риски, связанные с изображениями и текстом, в моделях Claude 3. Многоязычное тестирование включало партнёрство с сингапурским Infocomm Media Development Authority на четырёх языках: английском, тамильском, китайском (мандаринском) и малайском. Anthropic также называет краудсорсинговый и общественный red teaming, в том числе мероприятия в AI Village на DEF CON. [1]
Системная карта Claude Opus 5 от 24 июля 2026 года показывает те же методы применительно к одному выпуску. В главе о защитных мерах используются однократные вредоносные и безобидные запросы, подсказки с неоднозначным контекстом и многоходовые диалоги, в которых симулированный пользователь постепенно подводит разговор к вреду. Безвредность приводится вместе с избыточными отказами: по данным карты, модель сохранила высокую долю безвредных ответов на вредоносные запросы и при этом один из самых низких уровней избыточных отказов на безобидные. Глава об агентной безопасности охватывает злонамеренное использование агентов для программирования и управления компьютером, а также устойчивость к prompt injection при программировании, управлении компьютером и работе в браузере. [7]
Системная карта определяет prompt injection как вредоносную инструкцию, скрытую в результатах инструментов, которые обрабатывает агент, и отмечает, что риск наиболее высок, когда агент одновременно имеет доступ к частным данным и может действовать от имени пользователя. В ней также сообщается, что инструкции по безопасности в системном промпте claude.ai улучшили обработку моделью вредоносных запросов по сравнению с API без системного промпта. [7] Второй вывод напрямую касается внедряющих организаций, поскольку системный промпт находится на их стороне.
Responsible Scaling Policy версии 3.4, действующая с 8 июля 2026 года, заранее устанавливает пороги возможностей, требует формальных оценок с интервалом в шесть месяцев и предусматривает внешних рецензентов отчётов о рисках. [4] Фиксация порогов до тестирования ограничивает соблазн переосмыслить результат задним числом, и эта практика переносится на любую организацию, определяющую критерии выпуска.
Работа, которую может выполнить только разработчик модели
Red teaming пограничных угроз (frontier threats) направлен на химические, биологические, радиологические и ядерные (CBRN) риски, кибербезопасность и риски автономного ИИ. В публикации 2023 года описаны эксперты предметных областей с многолетним опытом, определявшие модели угроз, более 100 часов экспертного зондирования и шестимесячное исследование в области биобезопасности объёмом более 150 часов. [3] В публикации марта 2025 года описаны кибероценки на основе заданий формата capture-the-flag и симулированных сетевых сред; там же говорится, что Frontier Red Team работала с US AI Safety Institute, UK AI Security Institute и Национальным управлением ядерной безопасности США (NNSA), с последним — над засекреченными оценками знаний в ядерной и радиологической областях. [2]
Transparency Hub компании Anthropic сообщает, что компания использует как внутренний, так и внешний red teaming и что UK AI Security Institute, US Center for AI Standards and Innovation и Model Evaluation and Threat Research (METR) провели дополнительное тестирование её моделей. Там же перечислены программы bug bounty на HackerOne. [5] Системная карта Opus 5 включает тестирование на киберполигоне от UK AI Security Institute и оценку согласованности (alignment) на основе автоматизированного поведенческого аудита, а также главу о благополучии модели. [7] Страница Transparency Hub не указывает, какой институт тестировал конкретную модель до выпуска, поэтому роль каждого на этапе до развёртывания здесь не устанавливается сверх того, что сообщает системная карта.
Внешнее и краудсорсинговое тестирование — отдельная категория. По данным HackerOne, конкурс Anthropic по jailbreak проходил с 3 по 10 февраля 2025 года, в нём участвовали 339 человек, было более 300 000 диалоговых взаимодействий и восемь уровней сложности, а четыре команды разделили вознаграждения на 55 000 долларов США. Среди успешных техник были закодированные промпты и шифры, ролевая игра, замена вредоносных ключевых слов безобидными и prompt injection. [6] Для Opus 5 системная карта называет трёх внешних тестировщиков по контракту: один потратил около 100 часов и выполнил одно задание с промптами под конкретную задачу, второй потратил около 16 часов без успешного jailbreak, третий запускал автоматизированного атакующего со 150 попытками на задание, также без успеха. [7]
Что остаётся за внедряющей организацией
Ни одно из описанных выше тестирований разработчика не оценивает конкретное приложение. Следующее остаётся за организацией, развёртывающей модель, и сама системная карта указывает на несколько из этих пунктов, например показывая, что системные промпты меняют поведение модели и что агенты наиболее уязвимы, когда сочетают доступ к частным данным со способностью действовать. [7]
- Системный промпт и его ограничения, в том числе их поведение под многоходовым давлением.
- Данные RAG и косвенная prompt injection: любой документ, страница или письмо, попавшие в контекст, могут нести инструкции.
- Инструменты, полномочия агента и то, что внедрённая инструкция могла бы с ними сделать.
- Обработка вывода модели до того, как он попадёт в браузер, оболочку, базу данных или к человеку.
- Цепочка поставок, включая сторонние плагины и серверы Model Context Protocol (MCP).
- Злоупотребление затратами, например бесконечные циклы или запросы, расходующие платные токены.
- Изоляция выполнения кода и работы в браузере, а также контроль исходящего сетевого доступа.
- Журналирование, мониторинг и контрольные точки выпуска, определяющие, когда изменение можно выпускать.
Практики, которые стоит перенять
- Привлекайте внешних специалистов по red teaming или проводите закрытую программу bug bounty перед крупными выпусками. Практика самой Anthropic включает и то и другое: внешних тестировщиков по контракту для каждого выпуска и публичный конкурс по jailbreak с вознаграждениями.
- Проводите проверку поведения агентов в духе оценки согласованности: просматривайте выборку журналов использования инструментов и ищите попытки обойти ограничения, как это делал мониторинг Anthropic при внутреннем развёртывании.
- Составляйте короткую внутреннюю системную карту для каждого выпуска: что тестировалось, какие тесты не прошли, избыточные отказы наряду с вредом и известные пробелы.
- Устанавливайте пороги выпуска до тестирования, следуя подходу Responsible Scaling Policy.
- Тестируйте prompt injection через каждый канал, который читает агент, а не только через пользовательский ввод.
Эти методы подробнее рассматриваются в курсе FireAI University о фреймворках безопасности ИИ и red teaming.
Значение для FireAI
FireAI работает на Mac, ниже уровня любой модели. Правила разрешают или блокируют приложение либо отдельный адрес назначения для этого приложения, поэтому локальный ИИ-инструмент можно ограничить только нужными ему хостами. Это ограничивает, куда могут уйти данные, если приложение поведёт себя неправильно. FireAI не тестирует модели, не обнаруживает prompt injection, не читает промпты и не фильтрует вывод моделей.
Ограничения
- Заметка опирается только на то, что опубликовали Anthropic и HackerOne. Внутренние процессы Anthropic за этими пределами не видны, а опубликованные сводки избирательны.
- Источники относятся к разным датам, с июля 2023 по июль 2026 года, и методы могли измениться со времени более ранних публикаций.
- Результаты, описанные в системной карте, сообщает сам разработчик, за исключением работы, приписанной названным внешним тестировщикам.
- Заметка описывает одного разработчика. Другие поставщики публикуют иные материалы, а сопоставление с практикой внедряющих организаций — это обобщение, а не вывод из источников.
Какое место здесь занимают FireAI и HisnLabs
Тестирование модели заканчивается на уровне API. То, куда приложение или агент может обращаться с вашего Mac, — отдельный уровень контроля, и его обеспечивает FireAI.
FireAI — это собственный продукт HisnLabs: ИИ-файрвол, работающий прямо на вашем Mac. Он показывает простым языком каждое соединение, которое устанавливают ваши приложения, и позволяет вам решать, что покидает ваш Mac, — его ИИ работает локально, поэтому ваш трафик никогда не отправляется ни нам, ни кому-либо ещё. Команда исследователей безопасности HisnLabs — это те, кто поддерживает точность этих решений: они каталогизируют, какие домены являются обычной телеметрией, а какие — реальным сервисом, отслеживают страну и сеть, стоящие за соединением, и обучают локальную модель (функцию FireAI Pilot) на реальных шаблонах трафика — и ничего из этого не покидает ваш Mac.
Вы можете прочитать о технических решениях, лежащих в его основе, или попробовать FireAI в течение 17 дней на странице FireAI от HisnLabs.