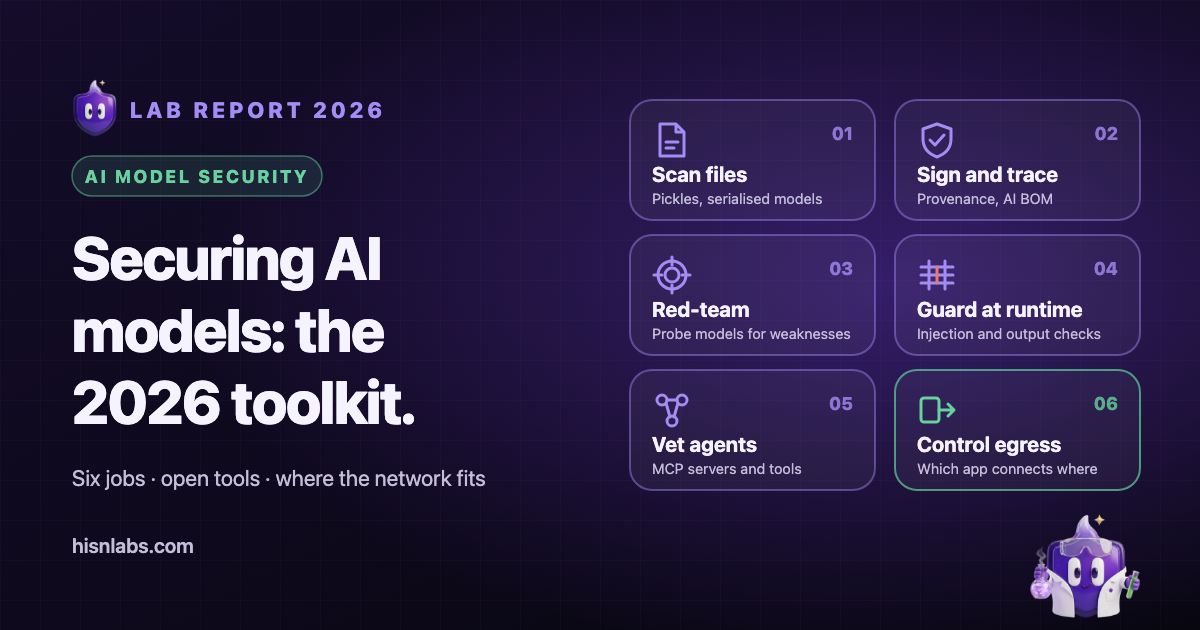
A segurança de modelos de IA não é uma disciplina única, mas seis tarefas, cada uma com as suas ferramentas: analisar ficheiros de modelos, estabelecer a proveniência, sondar um modelo em busca de fragilidades, protegê-lo em tempo de execução, avaliar as ferramentas de agente que o rodeiam e limitar os destinos a que a aplicação que o aloja se pode ligar. Este levantamento, preparado pela HisnLabs, a criadora do FireAI, abrange ferramentas abertas cujos repositórios ou documentação foram lidos a 30 de setembro de 2026. As licenças, os responsáveis e o estado são indicados tal como as fontes primárias os apresentam, e nenhuma ferramenta é classificada acima de outra, porque as tarefas não concorrem entre si.
Âmbito e método
Cada ferramenta só foi incluída se o seu repositório ou documentação oficial pôde ser aberto, a sua licença identificada e o seu estado de manutenção verificado (arquivada ou ativa, e a data da versão mais recente quando a página de versões a indica). As versões abaixo referidas são as mais recentes à data da leitura. Nada aqui é uma medição de desempenho: as fontes não fornecem resultados de deteção comparáveis, e nenhum é alegado. As plataformas comerciais são omitidas, salvo quando o tema é um componente aberto.
As categorias seguem a ordem pela qual um modelo atravessa um projeto: um ficheiro é descarregado, a sua origem é verificada, o modelo é testado, é implementado atrás de proteções, é ligado a ferramentas, e a aplicação que o executa acede à rede. O OWASP Top 10 for Large Language Model Applications, mantido no âmbito do OWASP GenAI Security Project, é o vocabulário comum habitual para os riscos ao nível da aplicação nas categorias três a cinco.
1. Análise de ficheiros de modelos
Muitos ficheiros de modelos são serializados com o formato pickle do Python, que pode executar código ao ser carregado. A documentação da Hugging Face afirma que carregar um pickle «means that code can be executed» e indica os opcodes GLOBAL, STACK_GLOBAL e REDUCE como os que representam a ameaça. Hugging Face: Pickle scanning Os scanners leem as instruções do ficheiro sem o carregar e assinalam importações perigosas.
ModelScan
O ModelScan é mantido pela Protect AI sob a licença Apache-2.0. Analisa formatos baseados em pickle (PyTorch, scikit-learn, XGBoost, joblib, cloudpickle), TensorFlow SavedModel e ficheiros Keras H5 e V3, classifica os resultados por gravidade e termina com códigos de saída adequados a pipelines de CI. A versão mais recente na sua página é a v0.8.8, de 18 de fevereiro de 2026, e o repositório registava atividade a 28 de setembro de 2026. Use-o como barreira antes de um modelo descarregado entrar numa build. Limitação: o README descreve uma deteção baseada em assinaturas que pode produzir falsos positivos e falsos negativos, e os resultados exigem análise humana.
picklescan
O picklescan é um scanner sob licença MIT mantido por uma conta individual, mmaitre314. A documentação da Hugging Face refere o picklescan entre as ferramentas que desenvolveu para o Hub. A versão mais recente é a v1.0.5, de 1 de julho de 2026. Analisa ficheiros pickle, arquivos PyTorch e contentores ZIP, e pode analisar um caminho local, um URL ou um modelo da Hugging Face. Use-o para uma verificação rápida num script. Limitação: identifica operações perigosas por padrões, pelo que uma técnica nova pode passar, e reporta os resultados sem os remover.
fickling
O fickling, da Trail of Bits, está licenciado sob LGPL-3.0. É descrito como descompilador, analisador estático e reescritor de bytecode para pickle. Pode descompilar um pickle em Python legível, verificar a segurança por análise estática e gerar um erro antes de carregar um ficheiro inseguro. A versão mais recente é a v0.1.12, de 26 de junho de 2026. Use-o quando um resultado tem de ser compreendido e não apenas assinalado. Limitação: é uma ferramenta de análise para pickle e não abrange os outros formatos que o ModelScan lê. Os termos da sua licença diferem das licenças permissivas dos outros scanners.
Análise no Hugging Face Hub e safetensors
O Hub analisa todos os ficheiros enviados com o ClamAV e com uma análise de importações pickle que enumera as importações dentro de cada ficheiro serializado e destaca as suspeitas. Hugging Face: file scanning Mostra também, nos repositórios públicos, os resultados de um scanner de terceiros, o Guardian da Protect AI. Hugging Face: Protect AI Limitação, nas palavras da Hugging Face: a análise de pickle não é totalmente infalível, as suas listas são mantidas na medida do possível, e cabe ao utilizador verificar o que é seguro. A alternativa estrutural é o safetensors, um formato Apache-2.0 mantido pela Hugging Face que guarda tensores sem conteúdo executável. Elimina o risco do pickle para os pesos, mas não indica se os próprios pesos são fiáveis.
2. Proveniência, assinatura e impressão digital de modelos
A análise pergunta se um ficheiro é perigoso de carregar. A proveniência pergunta quem o produziu e se foi alterado desde então. As duas questões exigem ferramentas diferentes.
Sigstore model-transparency
O model-transparency é um projeto Apache-2.0 da organização Sigstore que assina e verifica modelos de aprendizagem automática. Pode assinar através do Sigstore, ou com chaves, certificados ou dispositivos PKCS #11, e produz um pacote que contém um envelope DSSE com uma declaração in-toto. A sua versão mais recente é a v1.1.1, de 10 de outubro de 2025, com commits em setembro de 2026. Use-o para permitir que um consumidor verifique que os ficheiros que tem são os que um editor assinou. Limitações: a documentação indica suporte para o hashing de ficheiros e de fragmentos de ficheiros, não de tensores individuais, e uma assinatura válida prova a origem e a integridade, não que o modelo seja seguro. A Hugging Face faz a mesma distinção para os commits assinados, que garantem «the origin of the file» e não que este seja seguro.
Listas de materiais de IA e de ML
O CycloneDX, mantido pela OWASP Foundation e pelo TC54 da Ecma International, inclui uma Machine Learning Bill of Materials (ML-BOM) entre os tipos de BOM suportados. A sua versão mais recente, a 1.7, foi publicada a 21 de outubro de 2025, e os seus esquemas são Apache-2.0. O perfil de IA do SPDX 3.0 documenta componentes de IA como modelos, conjuntos de dados e prompts num único registo interligado. Use qualquer um deles para manter um inventário dos modelos, conjuntos de dados e versões que um produto contém, que é aquilo de que uma resposta a incidentes precisa em primeiro lugar. Limitação: uma BOM regista o que um autor declara. Nenhum dos formatos verifica a declaração.
Ferramentas de investigação em impressão digital e marca de água
O Instructional Fingerprinting é o código de um artigo académico (arXiv 2401.12255) que incorpora uma impressão digital num modelo de linguagem para que o proprietário possa mais tarde testar se outro modelo deriva dele. É código de investigação sob licença MIT, e a última atualização do repositório data de julho de 2024. O MarkLLM, do grupo THU-BPM, é um conjunto de ferramentas Apache-2.0 para aplicar marcas de água ao texto que um LLM gera, apresentado como demonstração na EMNLP 2024. Os dois respondem a questões diferentes: o primeiro marca um modelo, o segundo marca o que ele produz. Use-os para estudar a atribuição, não como controlo em produção. Limitação: ambos são artefactos de investigação, e nenhum substitui a assinatura de um ficheiro distribuído.
3. Red teaming de LLM e análise de vulnerabilidades
Estas ferramentas enviam entradas adversariais a um modelo ou aplicação e registam a forma como responde. Testam comportamento, não ficheiros.
garak
O garak é um scanner de vulnerabilidades de LLM sob Apache-2.0 mantido pela NVIDIA. O seu README indica que verifica «if an LLM can be made to fail in a way we don’t want», com sondas para injeção de prompts, fuga de dados, alucinação, toxicidade e jailbreaks, cada uma associada a um detetor. A versão mais recente é a v0.17.0, de 9 de setembro de 2026. Use-o como análise de base abrangente de um endpoint de modelo. Limitações: precisa de acesso por API ou de uma implementação local do alvo, algumas sondas consomem muitos recursos, e o README refere suporte limitado para modelos de visão e o estado de protótipo de algumas sondas.
PyRIT
O PyRIT é um framework sob licença MIT descrito como concebido para profissionais e engenheiros de segurança identificarem riscos em sistemas de IA generativa. É mantido pela Microsoft, e a versão mais recente é a v1.1.0, de 4 de setembro de 2026. O repositório anterior, na organização Azure, foi arquivado a 27 de março de 2026 com uma indicação para o da Microsoft, pelo que as ligações para o endereço antigo apontam para uma cópia só de leitura. Use-o para campanhas de red team programadas e com várias interações, por uma equipa disposta a escrever código. Limitação: é um framework, não um scanner de um só comando.
promptfoo
O promptfoo é uma ferramenta de linha de comandos e biblioteca sob licença MIT para avaliar aplicações LLM e para red teaming e análise de vulnerabilidades, com integração em CI. A versão mais recente é a 0.123.1, de 18 de setembro de 2026. O seu README afirma: «Promptfoo is now part of OpenAI. Promptfoo remains open source and MIT licensed.» Use-o para integrar testes de prompts e verificações adversariais numa build. Limitação: os resultados dependem do fornecedor e do avaliador configurados, e a maioria dos fornecedores exige chaves de API. A mudança de proprietário é um facto de governação a ter em conta na escolha de uma ferramenta para trabalho regulado.
Giskard
O Giskard é uma biblioteca Python sob Apache-2.0 da organização Giskard-AI. A sua versão 3 tem dois componentes descritos como estáveis: giskard-checks, um framework de testes que usa cenários e avaliações LLM-as-judge, e giskard-scan, um scanner de vulnerabilidades de agentes. Use-o para testar agentes e sistemas com geração aumentada por recuperação. Limitações: a versão 3 requer Python 3.12 ou posterior, e a versão 2, que abrangia a análise de aprendizagem automática tabular e clássica, já não é mantida ativamente.
4. Proteções em tempo de execução e deteção de injeção de prompts
As proteções situam-se no percurso dos pedidos e classificam ou restringem as entradas e saídas enquanto a aplicação corre.
Llama Guard, Prompt Guard e LlamaFirewall
O projeto Purple Llama da Meta reúne salvaguardas para modelos abertos. O Llama Guard é uma família de modelos de moderação de entradas e saídas. O Prompt Guard 2 é descrito como um classificador leve para tentativas diretas de injeção de prompts, e o LlamaFirewall combina-o com um scanner de verificação de alinhamento e um scanner de código para agentes. Segundo a tabela de licenças do projeto, os modelos são distribuídos sob as Llama Community Licences, e outros componentes, como o Code Shield e as avaliações, estão sob MIT. Os modelos na Hugging Face têm acesso condicionado. Use-os quando for aceitável um pequeno classificador à frente de um modelo. Limitações: um classificador reduz as tentativas semelhantes a padrões conhecidos e não elimina a classe de ataque.
NeMo Guardrails
O NeMo Guardrails é um conjunto de ferramentas Apache-2.0 da NVIDIA para acrescentar proteções programáveis a aplicações LLM, usando uma linguagem de modelação chamada Colang para controlar o fluxo do diálogo. A versão mais recente é a v0.24.1, de 16 de setembro de 2026. Use-o para restringir temas, formatos e percursos de diálogo. Limitação: as proteções são políticas escritas pelo programador, pelo que a sua cobertura não vai além do que foi previsto.
Rebuff e LLM Guard, agora arquivados
O Rebuff, um detetor de injeção de prompts que se reforça a si próprio, com heurísticas, uma verificação por LLM, uma base vetorial de ataques anteriores e tokens canário, foi arquivado a 16 de maio de 2025. O seu README afirma que se trata de um protótipo e que não pode oferecer proteção completa contra a injeção de prompts. O LLM Guard, um conjunto de scanners de entrada e saída sob licença MIT do mesmo responsável, foi arquivado em julho de 2026. Ambos continuam legíveis para consulta. Ilustram um ponto prático: os projetos de deteção podem perder os seus responsáveis, pelo que uma proteção deve ser substituível.
5. Scanners de segurança de agentes e MCP
Os agentes acrescentam ferramentas, e as descrições das ferramentas são texto que o modelo lê. Os scanners deste grupo inspecionam essas ferramentas e a sua configuração.
Snyk Agent Scan
O Agent Scan, anteriormente MCP-Scan, é um scanner Apache-2.0 mantido pela Snyk. Deteta os componentes de agentes numa máquina, incluindo servidores MCP e skills em clientes como Claude, Cursor, VS Code e GitHub Copilot, e verifica-os quanto a injeção de prompts, envenenamento de ferramentas e problemas relacionados. A versão mais recente é a v0.6.8, de 29 de setembro de 2026. Use-o para auditar o que uma máquina de desenvolvimento tem instalado. Limitações: o README indica que de momento não aceita contribuições externas e que existem duas linhas de versões com formatos de saída diferentes.
Cisco MCP Scanner
O MCP Scanner é uma ferramenta Apache-2.0 da Cisco AI Defense. Analisa ferramentas, prompts, recursos e dependências MCP com três motores que podem correr isoladamente ou em conjunto: regras YARA, análise por LLM e a API da Cisco AI Defense. A versão mais recente é a 4.8.4, de 28 de agosto de 2026. Use-o para verificar um servidor antes de o adotar. Limitação: os motores de LLM e de API precisam de credenciais externas, e a análise da descrição de um servidor diz pouco sobre o que o seu código faz após uma atualização.
6. O lugar dos controlos de rede
As ferramentas acima examinam ficheiros, modelos, prompts e configurações. Nenhuma decide que aplicação pode abrir uma ligação a que servidor. Esse é o papel do controlo de saída, e é relevante porque os riscos das secções anteriores convergem na rede: um runtime de modelo adulterado, uma ferramenta envenenada ou um agente vítima de injeção tem de alcançar um destino para exfiltrar dados ou receber instruções.
O FireAI, desenvolvido pela HisnLabs, é uma firewall de saída para macOS. Funciona como filtro de conteúdo Network Extension da Apple, identifica cada app pela sua assinatura de código e pode permitir, bloquear ou perguntar para cada destino, com regras por app, domínio ou endereço. Aplicado ao trabalho com IA num Mac, isto significa que um servidor de inferência, um agente de programação ou um cliente MCP pode ser limitado aos destinos de que a sua tarefa necessita, e que um novo destino exige uma decisão. A documentação do filtro descreve o que o FireAI vê: identidade da app, anfitrião ou endereço remoto, porta e protocolo.
O FireAI não analisa ficheiros de modelos, não verifica assinaturas, não faz red teaming de modelos nem classifica prompts. Não lê o conteúdo de ligações cifradas, pelo que não consegue distinguir um pedido legítimo de um injetado quando ambos se dirigem a um destino permitido. Complementa as ferramentas acima e não substitui nenhuma delas.
Comparação
| Ferramenta | Tarefa | Responsável | Licença | Estado observado a 30 set. 2026 |
|---|---|---|---|---|
| ModelScan | Análise de ficheiros de modelos | Protect AI | Apache-2.0 | Ativa, v0.8.8 |
| picklescan | Análise de pickle | mmaitre314 | MIT | Ativa, v1.0.5 |
| fickling | Análise aprofundada de pickle | Trail of Bits | LGPL-3.0 | Ativa, v0.1.12 |
| safetensors | Formato seguro de pesos | Hugging Face | Apache-2.0 | Ativa |
| model-transparency | Assinatura de modelos | Sigstore | Apache-2.0 | Ativa, v1.1.1 |
| CycloneDX | Especificação ML-BOM | OWASP, Ecma TC54 | Apache-2.0 (esquemas) | Ativa, 1.7 |
| Instructional Fingerprinting | Impressão digital de modelos (investigação) | Autores do artigo | MIT | Última atualização em julho de 2024 |
| MarkLLM | Marca de água em texto (investigação) | THU-BPM | Apache-2.0 | Ativa |
| garak | Análise de vulnerabilidades | NVIDIA | Apache-2.0 | Ativa, v0.17.0 |
| PyRIT | Framework de red team | Microsoft | MIT | Ativa, v1.1.0 |
| promptfoo | Avaliações e red teaming | Promptfoo, parte da OpenAI | MIT | Ativa, 0.123.1 |
| Giskard v3 | Testes e análise de agentes | Giskard-AI | Apache-2.0 | Ativa; v2 sem manutenção |
| Llama Guard, Prompt Guard | Modelos de proteção | Meta | Llama Community Licences | Modelos datados de abril de 2025 |
| NeMo Guardrails | Proteções programáveis | NVIDIA | Apache-2.0 | Ativa, v0.24.1 |
| Rebuff, LLM Guard | Deteção de injeção | Protect AI | Apache-2.0, MIT | Arquivadas |
| Agent Scan | Análise de agentes e MCP | Snyk | Apache-2.0 | Ativa, v0.6.8 |
| MCP Scanner | Análise de servidores MCP | Cisco AI Defense | Apache-2.0 | Ativa, 4.8.4 |
| FireAI | Controlo de saída por app no macOS | HisnLabs | Comercial | Não analisa modelos |
Limitações
- Nenhuma ferramenta isolada cobre as seis tarefas. Uma análise de ficheiro sem resultados nada diz sobre o comportamento de um modelo, uma assinatura nada diz sobre a segurança, e uma análise de red team nada diz sobre o conteúdo de um ficheiro.
- Os scanners e as proteções são detetores. Podem falhar técnicas novas, como reconhece a documentação do ModelScan, do picklescan e do Rebuff, e a sua cobertura muda à medida que os ataques mudam.
- A manutenção é desigual. Dois projetos de deteção aqui listados estão arquivados, uma ferramenta mudou de proprietário, outra tem um responsável individual e um repositório de investigação não é alterado desde 2024. Verifique o estado de um projeto antes de construir sobre ele.
- Este levantamento limitou-se a ferramentas abertas com fontes primárias legíveis. Exclui plataformas comerciais e não compara resultados de deteção, porque as fontes não fornecem valores comparáveis.
- As licenças foram lidas nas páginas dos repositórios e nas tabelas de licenças. Verifique-as antes de qualquer redistribuição, em particular as Llama Community Licences e os termos LGPL do fickling.
- A camada de rede vê ligações, não significados. Um destino permitido pode ainda assim receber dados de um runtime de modelo comprometido.
O papel do FireAI e da HisnLabs
Analise o modelo, assine o modelo, teste o modelo. Depois decida a que destinos a sua app se pode ligar.
O FireAI é o produto da HisnLabs: uma firewall com IA que corre diretamente no seu Mac. Mostra, em linguagem clara, cada ligação que as suas aplicações fazem e deixa-o decidir o que sai do seu Mac — a IA funciona localmente, pelo que o seu tráfego nunca é enviado para nós nem para mais ninguém. A equipa de investigação em segurança da HisnLabs é quem mantém essas decisões fiáveis: cataloga que domínios são simples telemetria e quais são um serviço real, acompanha o país e a rede por detrás de uma ligação e treina o modelo local (a funcionalidade FireAI Pilot) com padrões de tráfego reais, sem que nada disso saia do seu Mac.
Pode ler as decisões técnicas por detrás dele, ou experimentar o FireAI durante 17 dias, em FireAI, da HisnLabs.