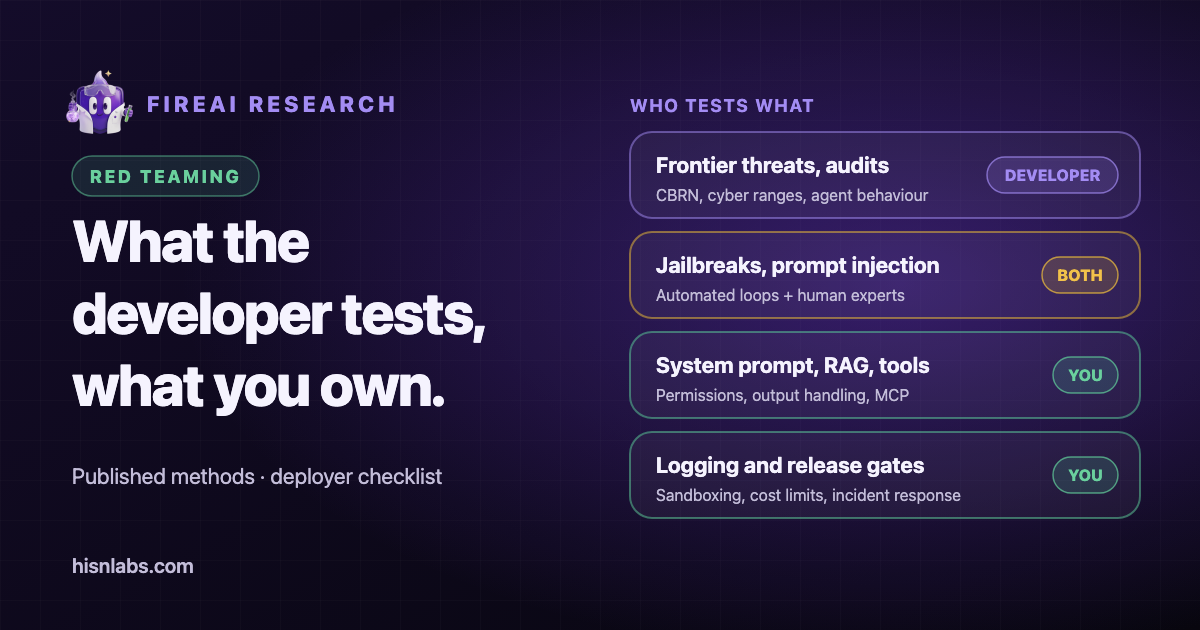
A Anthropic publica mais sobre a forma como testa o Claude do que a maioria dos criadores de modelos: artigos sobre red teaming, uma Responsible Scaling Policy e system cards para cada modelo. Esta nota resume esses documentos e distingue três grupos de trabalho: métodos usados tanto por criadores como por implementadores, trabalho que só um criador pode fazer e trabalho que fica com a organização que constrói uma aplicação sobre o modelo. Os processos internos que vão além do que a Anthropic publicou não são visíveis para leitores externos e não são aqui descritos. A nota é a segunda metade de um par com Responsabilidade partilhada nos LLM: quem protege o quê.
Contexto: duas questões diferentes
Um criador de modelos procura saber se um modelo é perigoso: se pode prestar um contributo sério ao desenvolvimento de armas, realizar operações cibernéticas ou comportar-se de forma enganadora. Um implementador procura saber se a sua aplicação é segura: se um documento, um resultado de ferramenta ou uma mensagem de utilizador construídos para o efeito podem levar a aplicação a divulgar dados ou a realizar uma ação que não deveria. Os métodos sobrepõem-se, mas as questões e as provas diferem, e um resultado favorável na primeira questão não responde à segunda.
O que a Anthropic descreve
Métodos que se sobrepõem à prática dos implementadores
Num artigo de 12 de junho de 2024, a Anthropic agrupa o seu red teaming em testes especializados por domínio, testes que usam modelos de linguagem, trabalho sobre novas modalidades e abordagens abertas. O red teaming automatizado usa uma dinâmica de equipa vermelha e equipa azul em que um modelo gera ataques. O red teaming multimodal abrangeu riscos de imagem e de texto nos modelos Claude 3 antes da implementação. Os testes multilingues incluíram uma parceria com a Infocomm Media Development Authority de Singapura em quatro línguas: inglês, tâmil, mandarim e malaio. A Anthropic refere também o red teaming por crowdsourcing e comunitário, incluindo eventos no AI Village da DEF CON. [1]
A system card do Claude Opus 5, datada de 24 de julho de 2026, mostra os mesmos métodos aplicados a uma versão. O seu capítulo sobre salvaguardas usa pedidos nocivos e benignos de uma única interação, prompts de contexto ambíguo e conversas com várias interações em que um utilizador simulado conduz gradualmente para o dano. Reporta a inocuidade a par da recusa excessiva, afirmando que o modelo manteve taxas elevadas de respostas inofensivas a pedidos nocivos, mantendo simultaneamente algumas das taxas mais baixas de recusa excessiva perante pedidos benignos. O seu capítulo sobre segurança agêntica abrange a utilização maliciosa de agentes de programação e de utilização do computador e a robustez à injeção de prompts em programação, utilização do computador e navegação. [7]
A system card define a injeção de prompts como uma instrução maliciosa oculta em resultados de ferramentas que um agente processa, e observa que o risco é maior quando um agente pode simultaneamente aceder a dados privados e agir em nome de um utilizador. Reporta também que as instruções de segurança no prompt de sistema do claude.ai reforçaram o tratamento de pedidos nocivos pelo modelo, em comparação com a API sem prompt de sistema. [7] Esta segunda conclusão diz diretamente respeito aos implementadores, porque o prompt de sistema faz parte do seu lado.
A Responsible Scaling Policy, versão 3.4, em vigor desde 8 de julho de 2026, fixa antecipadamente limiares de capacidade e exige avaliações formais a intervalos de seis meses, prevendo revisores externos dos relatórios de risco. [4] Fixar limiares antes dos testes limita a tentação de reinterpretar um resultado a posteriori, e a prática é transponível para qualquer organização que defina critérios de lançamento.
Trabalho que só um criador de modelos pode fazer
O red teaming de ameaças de fronteira visa riscos químicos, biológicos, radiológicos e nucleares (QBRN), a cibersegurança e os riscos de IA autónoma. Um artigo de 2023 descreve especialistas de domínio com décadas de experiência a definir modelos de ameaça, mais de 100 horas de sondagem por especialistas e um estudo de biossegurança de seis meses com mais de 150 horas. [3] Um artigo de março de 2025 descreve avaliações cibernéticas baseadas em desafios capture-the-flag e em ambientes de rede simulados, e afirma que a Frontier Red Team trabalhou com o US AI Safety Institute, o UK AI Security Institute e a US National Nuclear Security Administration (NNSA), esta última em avaliações classificadas de conhecimentos nucleares e radiológicos. [2]
O Transparency Hub da Anthropic indica que a empresa usa red teaming interno e externo e que o UK AI Security Institute, o US Center for AI Standards and Innovation e a Model Evaluation and Threat Research (METR) realizaram testes adicionais aos seus modelos. Enumera também programas de recompensa por falhas no HackerOne. [5] A system card do Opus 5 inclui testes em cyber range do UK AI Security Institute e uma avaliação de alinhamento baseada numa auditoria comportamental automatizada, bem como um capítulo sobre o bem-estar do modelo. [7] A página do Transparency Hub não indica que instituto testou um dado modelo antes do lançamento, pelo que o papel de cada um antes da implementação não é aqui estabelecido para além do que a system card reporta.
Os testes externos e por crowdsourcing constituem uma categoria distinta. O HackerOne relata que o desafio de jailbreak da Anthropic decorreu de 3 a 10 de fevereiro de 2025, com 339 participantes, mais de 300 000 interações de conversação e oito níveis de dificuldade, e que quatro equipas repartiram 55 000 dólares americanos em recompensas. As técnicas bem-sucedidas incluíram prompts codificados e cifras, role-play, substituição de palavras-chave nocivas por outras benignas e injeção de prompts. [6] Para o Opus 5, a system card identifica três avaliadores externos contratados: um dedicou cerca de 100 horas e concluiu uma tarefa com prompts específicos para essa tarefa, outro dedicou cerca de 16 horas sem um jailbreak bem-sucedido, e um terceiro executou um atacante automatizado com 150 tentativas por tarefa, sem sucesso. [7]
O que fica com os implementadores
Nenhum dos testes do criador acima descritos avalia uma aplicação concreta. Os pontos seguintes ficam a cargo da organização que implementa o modelo, e a própria system card aponta para vários deles, por exemplo ao mostrar que os prompts de sistema alteram o comportamento do modelo e que os agentes estão mais expostos quando combinam dados privados com a capacidade de agir. [7]
- O prompt de sistema e as suas proteções, incluindo o seu comportamento sob pressão ao longo de várias interações.
- Dados RAG e injeção indireta de prompts: qualquer documento, página ou email recuperado para o contexto pode conter instruções.
- Ferramentas, permissões do agente e o que uma instrução injetada poderia fazer com elas.
- O tratamento a jusante dos resultados do modelo antes de chegarem a um navegador, uma shell, uma base de dados ou uma pessoa.
- A cadeia de fornecimento, incluindo plugins de terceiros e servidores Model Context Protocol (MCP).
- O abuso de custos, como ciclos sem limite ou pedidos que consomem tokens pagos.
- O isolamento em sandbox da execução de código e da navegação, e o controlo do acesso de saída à rede.
- O registo, a monitorização e os critérios de lançamento que decidem quando uma alteração pode ser publicada.
Práticas que vale a pena adotar
- Encomende red teaming externo, ou organize um programa privado de recompensa por falhas, antes de lançamentos importantes. A prática da própria Anthropic inclui ambos: avaliadores externos contratados para cada versão e um desafio público de jailbreak com recompensas.
- Aplique aos agentes uma verificação de comportamento ao estilo das avaliações de alinhamento: analise amostras de transcrições de utilização de ferramentas e procure tentativas de contornar restrições, como fez a monitorização da Anthropic para a implementação interna.
- Redija uma breve system card interna para cada versão: o que foi testado, que testes falharam, a recusa excessiva a par do dano e as lacunas conhecidas.
- Fixe limiares de lançamento antes dos testes, seguindo a abordagem da Responsible Scaling Policy.
- Teste a injeção de prompts através de todos os canais que um agente lê, não apenas da entrada do utilizador.
O curso da FireAI University sobre quadros de segurança de IA e red teaming aborda estes métodos em mais pormenor.
Relevância para o FireAI
O FireAI opera no Mac, abaixo de qualquer modelo. As regras permitem ou bloqueiam uma app, ou um destino para essa app, pelo que uma ferramenta de IA local pode ser limitada aos anfitriões de que necessita. Isto limita para onde os dados podem ir se uma aplicação se comportar mal. O FireAI não testa modelos, não deteta injeção de prompts, não lê prompts nem filtra os resultados dos modelos.
Limitações
- A nota baseia-se apenas no que a Anthropic e o HackerOne publicaram. Os processos internos da Anthropic para além disso não são visíveis, e os resumos publicados são seletivos.
- As fontes têm datas diferentes, de julho de 2023 a julho de 2026, e os métodos podem ter mudado desde os artigos mais antigos.
- Os resultados descritos numa system card são reportados pelo próprio criador, com exceção do trabalho atribuído a avaliadores externos identificados.
- A nota descreve um único criador. Outros fornecedores publicam material diferente, e a comparação com a prática dos implementadores é uma síntese, não uma conclusão das fontes.
O papel do FireAI e da HisnLabs
Os testes do modelo terminam na API. O que uma app ou um agente pode alcançar a partir do seu Mac é um controlo distinto, e o FireAI disponibiliza-o.
O FireAI é o produto da HisnLabs: uma firewall com IA que corre diretamente no seu Mac. Mostra, em linguagem clara, cada ligação que as suas aplicações fazem e deixa-o decidir o que sai do seu Mac — a IA funciona localmente, pelo que o seu tráfego nunca é enviado para nós nem para mais ninguém. A equipa de investigação em segurança da HisnLabs é quem mantém essas decisões fiáveis: cataloga que domínios são simples telemetria e quais são um serviço real, acompanha o país e a rede por detrás de uma ligação e treina o modelo local (a funcionalidade FireAI Pilot) com padrões de tráfego reais, sem que nada disso saia do seu Mac.
Pode ler as decisões técnicas por detrás dele, ou experimentar o FireAI durante 17 dias, em FireAI, da HisnLabs.