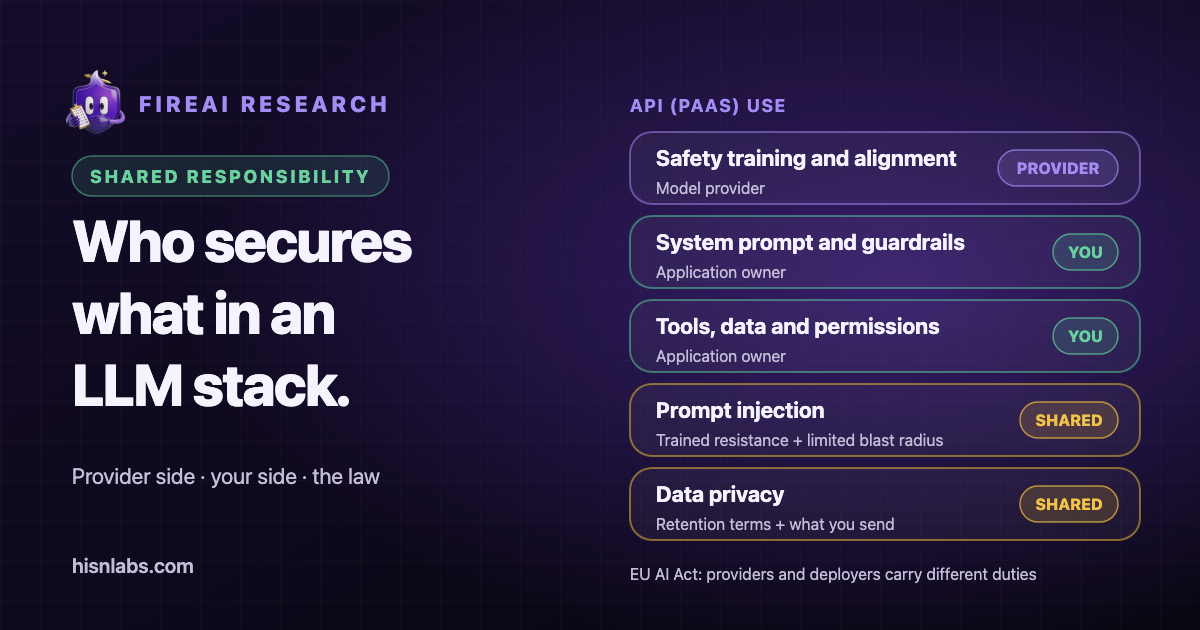
Organizacje budujące na hostowanym modelu językowym otrzymują od dostawcy model wytrenowany pod kątem bezpieczeństwa i platformę, a same pozostają odpowiedzialne za otaczającą go aplikację. Microsoft, Cloud Security Alliance i unijny AI Act dzielą tę pracę między dostawcę modelu a podmiot, który go wdraża, posługując się różnym słownictwem i mając różną moc prawną. Ta notatka porównuje te trzy ujęcia i proponuje praktyczny podział dla typowego przypadku modelu wykorzystywanego przez API. Uzupełnia artykuł Jak Anthropic przeprowadza red teaming Claude i co pozostawia Tobie, który na jednym opublikowanym przykładzie omawia stronę dostawcy.
Kontekst: model chmurowy rozszerzony na AI
Chmurowy model wspólnej odpowiedzialności przypisuje każdy mechanizm kontrolny dostawcy lub klientowi w zależności od typu usługi: oprogramowanie jako usługa (SaaS), platforma jako usługa (PaaS) lub infrastruktura jako usługa (IaaS). Zarówno Microsoft, jak i Cloud Security Alliance (CSA) rozszerzają tę koncepcję na generatywną AI. Rozszerzenie zmienia bardziej słownictwo niż logikę: im niżej w stosie buduje klient, tym więcej mechanizmów kontrolnych do niego należy.
Modele dostawców
Microsoft: platforma, aplikacja i użytkowanie
Model wspólnej odpowiedzialności za AI firmy Microsoft opisuje aplikację wykorzystującą AI jako trzy warstwy: platformę AI, aplikację AI i użytkowanie AI. Warstwa platformy udostępnia model przez API i obejmuje system bezpieczeństwa filtrujący szkodliwe dane wejściowe i wyjściowe. Warstwa aplikacji to interfejs, z którego korzysta użytkownik, z ugruntowaniem (grounding), wtyczkami i łącznikami danych, i wymaga ona własnego systemu bezpieczeństwa aplikacji. Warstwa użytkowania dotyczy tego, jak ludzie korzystają z tej możliwości, a Microsoft wskazuje tu kontrolę tożsamości i dostępu, zasady dopuszczalnego użytkowania oraz edukację użytkowników. [1]
To, jaka część każdej warstwy należy do klienta, zależy od typu wdrożenia. Strona stwierdza, że odpowiedzialność różni się w przypadku SaaS, PaaS i IaaS, i zaleca rozpoczęcie od ofert SaaS, takich jak Copilot, przejście do usług PaaS, takich jak Azure OpenAI Service, dopiero wtedy, gdy gotowe możliwości nie wystarczają, a budowę własnych modeli pozostawia organizacjom z głęboką wiedzą specjalistyczną. Strona dodaje, że wskazówki mają charakter ilustracyjny, są używane w sensie ładu organizacyjnego i nie zmieniają żadnej umowy z Microsoft. [1]
Microsoft: rozszerzenie na agentów
Druga strona Microsoftu dotyczy agentów, które odróżnia od zwykłego modelu, ponieważ agent działa bez zatwierdzania każdego kroku przez człowieka, planuje i wykonuje pętle, przechowuje pamięć, ma własną tożsamość i może współdziałać z innymi agentami. Dodaje trzy warstwy: orkiestrację agenta, narzędzia i działania oraz pamięć i stan. W jej macierzy odpowiedzialności w przypadku PaaS klient zachowuje instrukcje i zakres działania agenta, uprawnienia dla poszczególnych narzędzi oraz zatwierdzanie przez człowieka działań o dużym wpływie, a środowisko uruchomieniowe i platforma orkiestratora należą do Microsoftu. [2]
Strona wymienia obowiązki, które zawsze pozostają po stronie klienta: dane, tożsamość i zasada minimalnych uprawnień, autoryzacja działań, nadzór ludzki oraz dopuszczalne użytkowanie i ład organizacyjny. Stwierdza też, że autonomia nigdy nie zmniejsza rozliczalności. [2]
Cloud Security Alliance: propozycja z 2023 roku
We wpisie na blogu z 28 lipca 2023 roku jeden z członków (fellow) CSA zaproponował model z trzema stronami: dostawcą usługi AI, użytkownikiem usługi AI, który buduje aplikację, oraz przedsiębiorstwem lub użytkownikiem końcowym tej aplikacji. Zgodnie z propozycją dostawca IaaS zapewnia infrastrukturę i modele bazowe, a użytkownik odpowiada za trenowanie, walidację danych, filtrowanie promptów i bezpieczeństwo aplikacji; w przypadku PaaS użytkownik zapewnia kontekst i bezpieczeństwo aplikacji; w przypadku SaaS użytkownik zarządza ugruntowaniem, filtrowaniem promptów i ochroną własności intelektualnej. Wpis przedstawia to jako propozycję rozdzielenia obowiązków, a nie jako standard. [3]
Prawo: unijny AI Act dzieli obowiązki według ról
Unijny AI Act przypisuje obowiązki według ról. Zgodnie z FAQ do wytycznych Komisji Europejskiej dostawcą modelu AI ogólnego przeznaczenia jest podmiot, który opracowuje model lub zleca jego opracowanie i wprowadza go do obrotu pod własną nazwą. Obowiązki dostawcy obejmują dokumentację techniczną, dokumentację dla dalszych twórców dotyczącą możliwości i ograniczeń, politykę zgodności z prawem autorskim oraz publiczne podsumowanie treści użytych do trenowania. Obowiązki te mają zastosowanie od 2 sierpnia 2025 roku. Modele, w przypadku których domniemywa się ryzyko systemowe, czyli trenowane z użyciem mocy obliczeniowej co najmniej 10^25 operacji zmiennoprzecinkowych, podlegają dalszym obowiązkom, w tym testom adwersaryjnym i zabezpieczeniom cyberbezpieczeństwa. [4]
To samo FAQ podaje 2 sierpnia 2026 roku jako datę, od której wobec tych dostawców stosuje się egzekwowanie, w tym kary pieniężne, oraz 2 sierpnia 2027 roku jako termin dla modeli wprowadzonych do obrotu przed 2 sierpnia 2025 roku. Stwierdza też, że dalszy twórca, który modyfikuje model, staje się dostawcą jedynie w wyjątkowych okolicznościach, na przykład gdy wykorzystuje ponad jedną trzecią pierwotnej mocy obliczeniowej użytej do trenowania, więc większość dostrajania (fine-tuning) nie przenosi roli dostawcy. [4]
Podmioty stosujące (deployers), czyli organizacje korzystające z systemów AI, mają odrębny zestaw obowiązków. Analiza kancelarii prawnej z 24 lipca 2026 roku wymienia jako obowiązki podmiotów stosujących od 2 sierpnia 2026 roku ujawnianie deepfake’ów oraz informowanie osób o rozpoznawaniu emocji i kategoryzacji biometrycznej. W przypadku systemów wysokiego ryzyka wymienia kompetentny nadzór ludzki, informowanie osób o wykorzystaniu AI oraz konsultacje z pracownikami. [6] Strona Komisji z harmonogramem dodaje, że podmioty stosujące muszą zapewnić nadzór ludzki i monitorowanie oraz zgłaszać poważne incydenty po wprowadzeniu systemów do obrotu. [5]
Odroczenie w ramach Digital Omnibus
Terminy dla systemów wysokiego ryzyka zostały przesunięte. Strona Komisji z harmonogramem podaje 2 grudnia 2027 roku dla systemów wysokiego ryzyka w obszarach wrażliwych, takich jak biometria, zatrudnienie i egzekwowanie prawa, oraz 2 sierpnia 2028 roku dla systemów wysokiego ryzyka wbudowanych w produkty regulowane, i przypisuje to Digital Omnibus on AI, który według jej opisu wchodzi w życie w lipcu 2026 roku. [5] Analiza Norton Rose Fulbright podaje te same dwie daty i stwierdza, że Omnibus został opublikowany w unijnym dzienniku urzędowym. [6] Dwa niezależne źródła zgadzają się zatem, że odroczenie zostało przyjęte, a nie jedynie zaproponowane. Te dwie daty nie przesuwają obowiązków dostawców modeli ogólnego przeznaczenia ani opisanych wyżej obowiązków w zakresie przejrzystości.
Podział pracy przy korzystaniu z modelu przez API
W przypadku PaaS, w którym aplikacja wywołuje hostowany model, źródła uzasadniają poniższy podział. Wiersze odpowiadające Microsoftowi wynikają z opisanych wyżej warstw platformy i aplikacji; wiersze dotyczące testowania ryzyk granicznych, dokumentacji systemu i kanałów zgłaszania podatności odzwierciedlają obowiązki dostawców w wytycznych UE oraz praktyki publikowane przez dostawców modeli. Tabela jest syntezą przygotowaną przez FireAI, a nie tekstem pochodzącym z któregokolwiek ze źródeł.
| Obszar | Strona dostawcy | Twoja strona |
|---|---|---|
| Zachowanie modelu | Trenowanie modelu pod kątem bezpieczeństwa i zgodności (alignment) | Prompt systemowy i zabezpieczenia aplikacji |
| Testowanie ryzyka | Testowanie ryzyk granicznych samego modelu | Testowanie aplikacji, w tym jej promptów, danych i narzędzi |
| Platforma | Bezpieczeństwo platformy i podstawowe filtry danych wejściowych i wyjściowych | Kontrole bezpieczeństwa aplikacji dotyczące treści, wtyczek i łączników |
| Dokumentacja | Karta systemowa i dokumentacja dla dalszych twórców | Zapoznanie się z nią i zapisanie, który model i która wersja zostały wdrożone |
| Dane i narzędzia | Nic poza umową dotyczącą API | Dane RAG, narzędzia, agenci i ich uprawnienia |
| Wyniki | Zwraca wygenerowany tekst | Dalsze przetwarzanie wyników: walidacja, escapowanie, zatwierdzanie przez człowieka |
| Eksploatacja | Kanał zgłaszania podatności modelu | Rejestrowanie, monitorowanie i reagowanie na incydenty w aplikacji |
| Ludzie | Warunki zasad użytkowania | Własne zasady użytkowania i szkolenie użytkowników |
Dwa obszary są wspólne w ścisłym sensie. Pierwszym jest wstrzykiwanie promptów: dostawca trenuje model tak, by opierał się wstrzykniętym instrukcjom, a podmiot wdrażający ogranicza, co wstrzyknięta instrukcja może osiągnąć, za pomocą uprawnień narzędzi i dostępu do danych. Strona Microsoftu dotycząca agentów opisuje ten sam podział, zalecając klientom traktowanie pobranych treści, wyników narzędzi i wiadomości innych agentów jako niezaufanych oraz zabezpieczanie działań o dużym wpływie. [2] Drugim jest prywatność danych: dostawca ustala warunki przechowywania i trenowania, a podmiot wdrażający decyduje, jakie dane w ogóle trafiają do promptu lub indeksu wyszukiwania.
Zalecenia
- Najpierw ustal typ wdrożenia (SaaS, PaaS lub samodzielny hosting) i zapisz, które wiersze powyższego podziału należą do organizacji.
- Testuj bezpośrednio stronę podmiotu wdrażającego: prompt systemowy, dane do wyszukiwania, uprawnienia narzędzi i przetwarzanie wyników. Testy modelu prowadzone przez dostawcę ich nie obejmują.
- Przed przyjęciem modelu przeczytaj kartę systemową dostawcy, jego warunki przechowywania danych i trenowania oraz ustal, gdzie znajduje się jego kanał zgłaszania podatności.
- Ogranicz to, co może zrobić wstrzyknięta instrukcja: narzędzia z minimalnymi uprawnieniami, ograniczony dostęp do danych i zatwierdzanie przez człowieka działań nieodwracalnych.
- Zdecyduj, jakie dane mogą trafiać do promptów, i prowadź dzienniki wystarczające do odtworzenia incydentu.
- Materiały do nauki o ramach bezpieczeństwa i red teamingu zawiera kurs FireAI University o ramach bezpieczeństwa AI i red teamingu.
Znaczenie dla FireAI
Lokalna aplikacja lub agent wywołujący API modelu jest aplikacją na Macu, a jej miejsca docelowe są widoczne dla FireAI. Activity pokazuje, które aplikacje łączyły się z siecią, a Rules pozwalają zezwolić aplikacji lub ją zablokować albo zrobić to dla konkretnego miejsca docelowego. Jest to jeden mechanizm kontrolny po stronie podmiotu wdrażającego, na pojedynczym Macu. FireAI nie analizuje promptów, nie ocenia wyników modelu, nie wykrywa wstrzykiwania promptów ani nie ocenia, czy dostawca spełnia jakikolwiek obowiązek prawny.
Ograniczenia
- Strony Microsoftu są wskazówkami dostawcy dotyczącymi produktów Azure, określają się jako ilustracyjne i nie zmieniają warunków umów. Tekst CSA jest propozycją z 2023 roku.
- Ta notatka nie stanowi porady prawnej. To, czy organizacja jest dostawcą, podmiotem stosującym lub operatorem systemu wysokiego ryzyka w rozumieniu AI Act, zależy od okoliczności, których ta notatka nie ocenia, a organy krajowe mogą interpretować akt odmiennie.
- Daty Digital Omnibus pochodzą ze strony Komisji z harmonogramem i z jednej analizy kancelarii prawnej. Tekst samego rozporządzenia nie został przeanalizowany na potrzeby tej notatki.
- Tabela dotycząca API jest syntezą, a poszczególni dostawcy umieszczają niektóre wiersze inaczej w swoich warunkach.
Jaką rolę odgrywają FireAI i HisnLabs
Po Twojej stronie linii jest też to, co opuszcza Maca. FireAI to pokazuje i pozwala Ci zdecydować.
FireAI to własny produkt HisnLabs: zapora sieciowa z AI działająca bezpośrednio na Macu. Pokazuje prostym językiem każde połączenie nawiązywane przez twoje aplikacje i pozwala ci decydować, co opuszcza twojego Maca — jej AI działa lokalnie, więc twój ruch nigdy nie jest wysyłany do nas ani do nikogo innego. Zespół badań nad bezpieczeństwem HisnLabs dba o to, by te decyzje pozostały trafne: kataloguje, które domeny to zwykła telemetria, a które prawdziwa usługa, śledzi kraj i sieć stojące za połączeniem oraz trenuje lokalny model (funkcję FireAI Pilot) na rzeczywistych wzorcach ruchu — a nic z tego nie opuszcza twojego Maca.
Możesz przeczytać o decyzjach technicznych, które za tym stoją, albo wypróbować FireAI przez 17 dni na FireAI od HisnLabs.