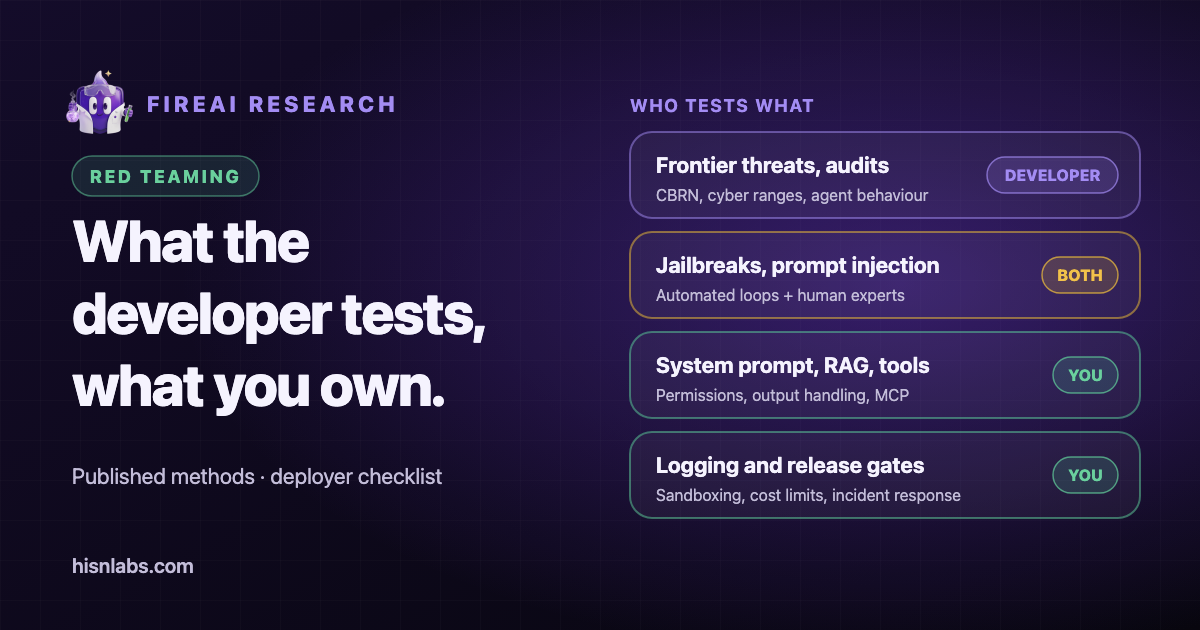
Anthropic publikuje o tym, jak testuje Claude, więcej niż większość twórców modeli: wpisy na blogu o red teamingu, Responsible Scaling Policy oraz karty systemowe (system cards) dla każdego modelu. Ta notatka streszcza te dokumenty i wyodrębnia trzy grupy prac: metody stosowane zarówno przez twórców, jak i przez wdrażających, prace, które może wykonać tylko twórca, oraz prace, które pozostają po stronie organizacji budującej aplikację na modelu. Procesy wewnętrzne wykraczające poza to, co Anthropic opublikował, nie są widoczne dla czytelników z zewnątrz i nie są tu opisywane. Notatka stanowi drugą część pary z artykułem Wspólna odpowiedzialność za LLM: kto zabezpiecza co.
Kontekst: dwa różne pytania
Twórca modelu pyta, czy model jest niebezpieczny: czy może istotnie pomóc w opracowywaniu broni, przeprowadzać operacje cybernetyczne lub zachowywać się w sposób zwodniczy. Wdrażający pyta, czy jego aplikacja jest bezpieczna: czy spreparowany dokument, wynik narzędzia lub wiadomość użytkownika mogą sprawić, że aplikacja ujawni dane lub podejmie działanie, którego nie powinna. Metody się pokrywają, ale pytania i dowody są różne, a pozytywny wynik w odniesieniu do pierwszego pytania nie odpowiada na drugie.
Co opisuje Anthropic
Metody pokrywające się z praktyką wdrażających
We wpisie z 12 czerwca 2024 roku Anthropic dzieli swój red teaming na testy prowadzone przez ekspertów dziedzinowych, testy wykorzystujące modele językowe, prace nad nowymi modalnościami oraz podejścia otwarte. Zautomatyzowany red teaming wykorzystuje dynamikę red team i blue team, w której ataki generuje model. Multimodalny red teaming obejmował ryzyka związane z obrazem i tekstem w modelach Claude 3 przed wdrożeniem. Testy wielojęzyczne obejmowały współpracę z singapurskim Infocomm Media Development Authority w czterech językach: angielskim, tamilskim, mandaryńskim i malajskim. Anthropic wymienia także red teaming crowdsourcingowy i społecznościowy, w tym wydarzenia w AI Village na DEF CON. [1]
Karta systemowa Claude Opus 5, datowana na 24 lipca 2026 roku, pokazuje te same metody zastosowane do jednego wydania. Jej rozdział o zabezpieczeniach wykorzystuje jednoturowe żądania szkodliwe i nieszkodliwe, prompty o niejednoznacznym kontekście oraz rozmowy wieloturowe, w których symulowany użytkownik stopniowo zmierza w kierunku szkody. Raportuje nieszkodliwość łącznie z nadmierną odmową (over-refusal), stwierdzając, że model utrzymał wysoki odsetek nieszkodliwych odpowiedzi na szkodliwe żądania przy jednym z najniższych odsetków nadmiernych odmów w odpowiedzi na żądania nieszkodliwe. Jej rozdział o bezpieczeństwie agentowym obejmuje złośliwe wykorzystanie agentów programistycznych i agentów obsługujących komputer oraz odporność na wstrzykiwanie promptów w programowaniu, obsłudze komputera i korzystaniu z przeglądarki. [7]
Karta systemowa definiuje wstrzykiwanie promptów jako złośliwą instrukcję ukrytą w wynikach narzędzi przetwarzanych przez agenta i odnotowuje, że ryzyko jest największe, gdy agent może zarówno sięgać do prywatnych danych, jak i działać w imieniu użytkownika. Podaje też, że instrukcje bezpieczeństwa w prompcie systemowym na claude.ai wzmocniły sposób, w jaki model obsługuje szkodliwe żądania, w porównaniu z API bez promptu systemowego. [7] Drugie ustalenie dotyczy bezpośrednio wdrażających, ponieważ prompt systemowy należy do ich strony.
Responsible Scaling Policy w wersji 3.4, obowiązująca od 8 lipca 2026 roku, z wyprzedzeniem ustala progi możliwości i wymaga formalnych ewaluacji w odstępach sześciomiesięcznych, a także przewiduje zewnętrznych recenzentów raportów o ryzyku. [4] Ustalenie progów przed testami ogranicza pokusę reinterpretowania wyniku po fakcie, a praktykę tę można przenieść do każdej organizacji, która definiuje kryteria wydania.
Prace, które może wykonać tylko twórca modelu
Red teaming zagrożeń granicznych (frontier threats) dotyczy ryzyk chemicznych, biologicznych, radiologicznych i jądrowych (CBRN), cyberbezpieczeństwa oraz ryzyk związanych z autonomiczną AI. Wpis z 2023 roku opisuje ekspertów dziedzinowych z wieloletnim doświadczeniem, którzy definiowali modele zagrożeń, ponad 100 godzin eksperckiego badania oraz sześciomiesięczne badanie z zakresu bezpieczeństwa biologicznego trwające ponad 150 godzin. [3] Wpis z marca 2025 roku opisuje ewaluacje cybernetyczne oparte na zadaniach typu capture-the-flag i symulowanych środowiskach sieciowych oraz stwierdza, że Frontier Red Team współpracował z US AI Safety Institute, UK AI Security Institute i amerykańską National Nuclear Security Administration (NNSA), z tą ostatnią przy niejawnych ewaluacjach wiedzy jądrowej i radiologicznej. [2]
Transparency Hub firmy Anthropic podaje, że firma stosuje zarówno wewnętrzny, jak i zewnętrzny red teaming oraz że UK AI Security Institute, amerykańskie Center for AI Standards and Innovation oraz Model Evaluation and Threat Research (METR) przeprowadziły dodatkowe testy jej modeli. Wymienia też programy bug bounty w HackerOne. [5] Karta systemowa Opus 5 zawiera testy na poligonie cybernetycznym (cyber range) przeprowadzone przez UK AI Security Institute i ocenę zgodności (alignment) opartą na zautomatyzowanym audycie zachowań, a także rozdział o dobrostanie modelu. [7] Strona Transparency Hub nie podaje, który instytut testował dany model przed wydaniem, więc rola każdego z nich przed wdrożeniem nie jest tu ustalona w zakresie wykraczającym poza to, co raportuje karta systemowa.
Testy zewnętrzne i crowdsourcingowe stanowią odrębną kategorię. HackerOne podaje, że wyzwanie jailbreakowe Anthropic trwało od 3 do 10 lutego 2025 roku, z udziałem 339 uczestników, ponad 300 000 interakcji czatowych i ośmioma poziomami trudności, a cztery zespoły podzieliły się nagrodami w wysokości 55 000 dolarów amerykańskich. Skuteczne techniki obejmowały zakodowane prompty i szyfry, odgrywanie ról, zastępowanie szkodliwych słów kluczowych nieszkodliwymi oraz wstrzykiwanie promptów. [6] W przypadku Opus 5 karta systemowa wymienia trzech zakontraktowanych testerów zewnętrznych: jeden poświęcił około 100 godzin i ukończył jedno zadanie przy użyciu promptów dostosowanych do zadania, drugi poświęcił około 16 godzin bez udanego jailbreaku, a trzeci uruchomił zautomatyzowanego atakującego ze 150 próbami na zadanie, bez powodzenia. [7]
Co pozostaje po stronie wdrażających
Żaden z opisanych wyżej testów twórcy nie ocenia konkretnej aplikacji. Poniższe kwestie pozostają po stronie organizacji wdrażającej model, a sama karta systemowa wskazuje na kilka z nich, na przykład pokazując, że prompty systemowe zmieniają zachowanie modelu oraz że agenci są najbardziej narażeni, gdy łączą prywatne dane ze zdolnością do działania. [7]
- Prompt systemowy i jego zabezpieczenia, w tym ich zachowanie pod presją wieloturową.
- Dane RAG i pośrednie wstrzykiwanie promptów: każdy dokument, strona lub wiadomość e-mail pobrane do kontekstu mogą zawierać instrukcje.
- Narzędzia, uprawnienia agenta i to, co wstrzyknięta instrukcja mogłaby z nimi zrobić.
- Dalsze przetwarzanie wyników modelu, zanim trafią do przeglądarki, powłoki, bazy danych lub człowieka.
- Łańcuch dostaw, w tym wtyczki firm trzecich i serwery Model Context Protocol (MCP).
- Nadużycia kosztowe, takie jak nieograniczone pętle lub żądania zużywające płatne tokeny.
- Izolacja wykonywania kodu i przeglądania stron oraz kontrola wychodzącego dostępu do sieci.
- Rejestrowanie, monitorowanie i bramki wydań, które decydują, kiedy zmiana może zostać wdrożona.
Praktyki warte przejęcia
- Przed większymi wydaniami zlecaj prace zewnętrznym zespołom red teamingowym lub prowadź prywatny program bug bounty. Praktyka Anthropic obejmuje oba rozwiązania: zakontraktowanych testerów zewnętrznych dla każdego wydania oraz publiczne wyzwanie jailbreakowe z nagrodami.
- Przeprowadzaj kontrolę zachowania agentów w duchu oceny zgodności: pobieraj próbki transkryptów użycia narzędzi i szukaj prób obejścia ograniczeń, tak jak robił to monitoring Anthropic przy wdrożeniu wewnętrznym.
- Dla każdego wydania napisz krótką wewnętrzną kartę systemową: co przetestowano, które testy zakończyły się niepowodzeniem, nadmierne odmowy obok szkodliwości oraz znane luki.
- Ustalaj progi wydania przed testami, zgodnie z podejściem Responsible Scaling Policy.
- Testuj wstrzykiwanie promptów przez każdy kanał, który czyta agent, a nie tylko przez dane wejściowe użytkownika.
Kurs FireAI University o ramach bezpieczeństwa AI i red teamingu omawia te metody bardziej szczegółowo.
Znaczenie dla FireAI
FireAI działa na Macu, poniżej jakiegokolwiek modelu. Reguły zezwalają aplikacji lub ją blokują, ewentualnie dla jednego miejsca docelowego tej aplikacji, więc lokalne narzędzie AI można ograniczyć do potrzebnych mu hostów. Ogranicza to, dokąd mogą trafić dane, jeśli aplikacja zachowa się niewłaściwie. FireAI nie testuje modeli, nie wykrywa wstrzykiwania promptów, nie czyta promptów ani nie filtruje wyników modelu.
Ograniczenia
- Notatka opiera się wyłącznie na tym, co opublikowały Anthropic i HackerOne. Procesy wewnętrzne Anthropic wykraczające poza to nie są widoczne, a opublikowane streszczenia są wybiórcze.
- Źródła pochodzą z różnych dat, od lipca 2023 do lipca 2026 roku, a metody mogły się zmienić od czasu starszych wpisów.
- Wyniki opisane w karcie systemowej są raportowane przez samego twórcę, z wyjątkiem prac przypisanych wymienionym z nazwy testerom zewnętrznym.
- Notatka opisuje jednego twórcę. Inni dostawcy publikują inne materiały, a porównanie z praktyką wdrażających jest syntezą, a nie ustaleniem pochodzącym ze źródeł.
Jaką rolę odgrywają FireAI i HisnLabs
Testowanie modelu kończy się na API. To, do czego aplikacja lub agent może dotrzeć z Twojego Maca, to osobna kontrola i zapewnia ją FireAI.
FireAI to własny produkt HisnLabs: zapora sieciowa z AI działająca bezpośrednio na Macu. Pokazuje prostym językiem każde połączenie nawiązywane przez twoje aplikacje i pozwala ci decydować, co opuszcza twojego Maca — jej AI działa lokalnie, więc twój ruch nigdy nie jest wysyłany do nas ani do nikogo innego. Zespół badań nad bezpieczeństwem HisnLabs dba o to, by te decyzje pozostały trafne: kataloguje, które domeny to zwykła telemetria, a które prawdziwa usługa, śledzi kraj i sieć stojące za połączeniem oraz trenuje lokalny model (funkcję FireAI Pilot) na rzeczywistych wzorcach ruchu — a nic z tego nie opuszcza twojego Maca.
Możesz przeczytać o decyzjach technicznych, które za tym stoją, albo wypróbować FireAI przez 17 dni na FireAI od HisnLabs.