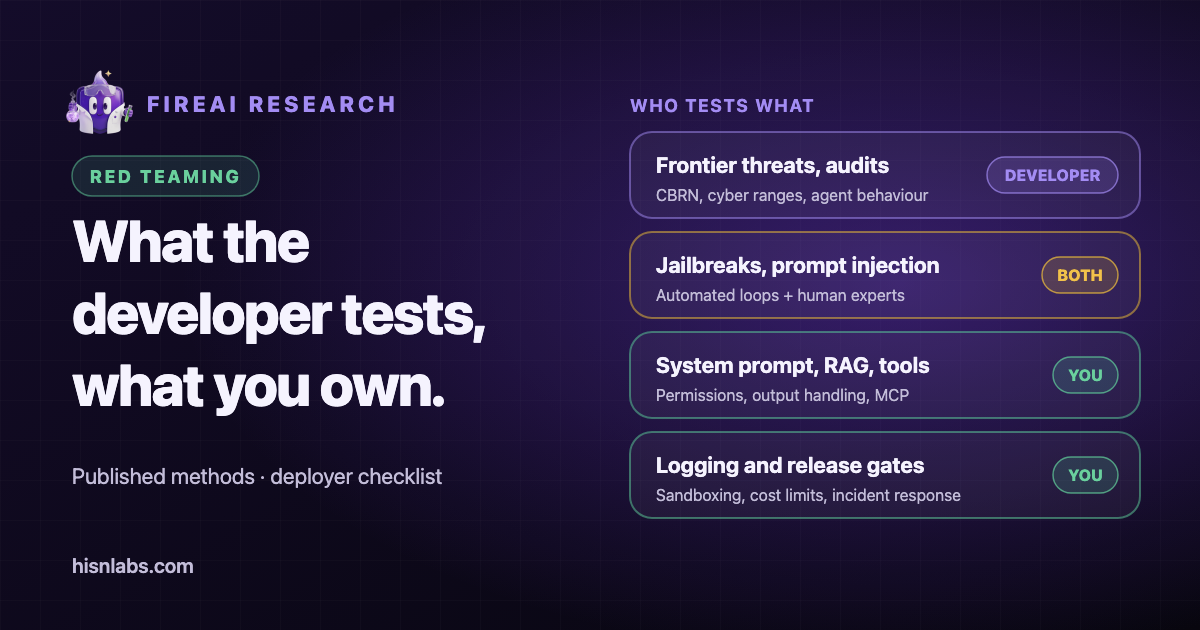
Anthropic publiserer mer om hvordan Claude testes enn de fleste modellutviklere: blogginnlegg om red teaming, en Responsible Scaling Policy og systemkort for hver modell. Dette notatet oppsummerer disse dokumentene og skiller mellom tre grupper av arbeid: metoder både utviklere og tjenesteeiere bruker, arbeid bare en utvikler kan gjøre, og arbeid som forblir hos organisasjonen som bygger en applikasjon på modellen. Interne prosesser utover det Anthropic har publisert, er ikke synlige for lesere utenfra og beskrives ikke her. Notatet er andre halvdel av et par med Shared responsibility for LLMs: who secures what.
Bakgrunn: to ulike spørsmål
En modellutvikler spør om en modell er farlig: om den kan gi vesentlig drahjelp til våpenutvikling, gjennomføre cyberoperasjoner eller opptre villedende. En tjenesteeier spør om applikasjonen er sikker: om et tilpasset dokument, et verktøyresultat eller en brukermelding kan få applikasjonen til å lekke data eller utføre en handling den ikke skal. Metodene overlapper, men spørsmålene og bevisene er forskjellige, og et bestått resultat på det første spørsmålet besvarer ikke det andre.
Hva Anthropic beskriver
Metoder som overlapper med tjenesteeieres praksis
I et innlegg fra 12. juni 2024 deler Anthropic sin red teaming inn i domenespesifikk ekspertesting, testing som bruker språkmodeller, arbeid med nye modaliteter og åpne tilnærminger. Automatisert red teaming bruker en dynamikk mellom red team og blue team der en modell genererer angrep. Multimodal red teaming dekket risiko knyttet til bilde og tekst i Claude 3-modellene før lansering. Flerspråklig testing omfattet et samarbeid med Singapores Infocomm Media Development Authority på fire språk: engelsk, tamil, mandarin og malayisk. Anthropic nevner også crowdsourcet red teaming og red teaming i fellesskap, blant annet arrangementer i DEF CONs AI Village. [1]
Systemkortet for Claude Opus 5, datert 24. juli 2026, viser de samme metodene anvendt på én lansering. Kapittelet om sikringstiltak bruker skadelige og harmløse enkeltforespørsler, prompter med tvetydig kontekst og samtaler over flere runder der en simulert bruker gradvis styrer mot skade. Det rapporterer harmløshet sammen med overdreven avvisning, og oppgir at modellen holdt en høy andel harmløse svar på skadelige forespørsler samtidig som den hadde blant de laveste andelene overdreven avvisning på harmløse. Kapittelet om agentisk sikkerhet dekker ondsinnet bruk av agenter for koding og computer use, samt robusthet mot promptinjeksjon i koding, computer use og nettleserbruk. [7]
Systemkortet definerer promptinjeksjon som en ondsinnet instruksjon skjult i verktøyresultater som en agent behandler, og påpeker at risikoen er størst når en agent både kan nå private data og handle på vegne av en bruker. Det rapporterer også at sikkerhetsinstruksjoner i systemprompten på claude.ai styrket modellens håndtering av skadelige forespørsler sammenlignet med API-et uten systemprompt. [7] Det andre funnet har direkte betydning for tjenesteeiere, fordi systemprompten er en del av tjenesteeierens side.
Responsible Scaling Policy, versjon 3.4, gjeldende fra 8. juli 2026, fastsetter terskler for kapabilitet på forhånd og krever formelle evalueringer med seks måneders mellomrom, og den åpner for eksterne vurderere av risikorapporter. [4] Å fastsette terskler før testing begrenser fristelsen til å omtolke et resultat i etterkant, og praksisen kan overføres til enhver organisasjon som definerer kriterier for lansering.
Arbeid bare en modellutvikler kan gjøre
Red teaming av grensetrusler retter seg mot kjemisk, biologisk, radiologisk og nukleær (CBRN) risiko, cybersikkerhet og risiko fra autonom KI. Et innlegg fra 2023 beskriver domeneeksperter med flere tiårs erfaring som definerer trusselmodeller, mer enn 100 timer med ekspertundersøkelser og en seks måneder lang biosikkerhetsstudie på mer enn 150 timer. [3] Et innlegg fra mars 2025 beskriver cyberevalueringer basert på capture-the-flag-oppgaver og simulerte nettverksmiljøer, og oppgir at Frontier Red Team samarbeidet med US AI Safety Institute, UK AI Security Institute og US National Nuclear Security Administration (NNSA), den siste om graderte evalueringer av nukleær og radiologisk kunnskap. [2]
Anthropics Transparency Hub oppgir at selskapet bruker både intern og ekstern red teaming, og at UK AI Security Institute, US Center for AI Standards and Innovation og Model Evaluation and Threat Research (METR) har gjennomført ytterligere testing av modellene. Den viser også til bug bounty-programmer på HackerOne. [5] Systemkortet for Opus 5 inkluderer testing i cyber range fra UK AI Security Institute og en samsvarsvurdering (alignment assessment) basert på en automatisert atferdsrevisjon, samt et kapittel om modellvelferd. [7] Siden på Transparency Hub oppgir ikke hvilket institutt som testet en gitt modell før lansering, så det enkelte instituttets rolle før lansering er ikke fastslått her utover det systemkortet rapporterer.
Ekstern og crowdsourcet testing er en egen kategori. HackerOne rapporterer at Anthropics jailbreak-utfordring pågikk fra 3. til 10. februar 2025 med 339 deltakere, mer enn 300 000 chatteinteraksjoner og åtte vanskelighetsnivåer, og at fire team delte 55 000 amerikanske dollar i dusører. Vellykkede teknikker omfattet kodede prompter og chiffer, rollespill, erstatning av skadelige nøkkelord med harmløse og promptinjeksjon. [6] For Opus 5 navngir systemkortet tre innleide eksterne testere: én brukte omtrent 100 timer og fullførte én oppgave med oppgavespesifikk prompting, én brukte rundt 16 timer uten vellykket jailbreak, og én kjørte en automatisert angriper med 150 forsøk per oppgave uten å lykkes. [7]
Hva som forblir hos tjenesteeiere
Ingen av utviklertestene ovenfor evaluerer en bestemt applikasjon. Følgende forblir hos organisasjonen som tar modellen i bruk, og systemkortet peker selv på flere av dem, for eksempel ved å vise at systemprompter endrer modellens atferd, og at agenter er mest eksponert når de kombinerer private data med evnen til å handle. [7]
- Systemprompten og dens beskyttelser, inkludert hvordan de oppfører seg under press over flere runder.
- RAG-data og indirekte promptinjeksjon: Ethvert dokument, enhver side eller e-post som hentes inn i konteksten, kan bære instruksjoner.
- Verktøy, agentens tillatelser og hva en injisert instruksjon kunne gjøre med dem.
- Videre håndtering av modellens utdata før de når en nettleser, et skall, en database eller en person.
- Leverandørkjeden, inkludert tredjeparts tillegg og Model Context Protocol-servere (MCP).
- Kostnadsmisbruk, som ubegrensede løkker eller forespørsler som forbruker betalte tokens.
- Sandkasse for kodekjøring og nettlesing, og kontroll av utgående nettverkstilgang.
- Logging, overvåking og lanseringsporter som avgjør når en endring kan leveres.
Praksis verdt å låne
- Engasjer eksterne red teamere, eller kjør et privat bug bounty-program, før større lanseringer. Anthropics egen praksis omfatter begge deler: innleide eksterne testere for hver lansering og en offentlig jailbreak-utfordring med dusører.
- Kjør en atferdskontroll i samsvarsstil på agenter: Ta stikkprøver av transkripsjoner av verktøybruk og se etter forsøk på å omgå begrensninger, slik Anthropics overvåking gjorde for intern bruk.
- Skriv et kort internt systemkort for hver lansering: hva som ble testet, hvilke tester som feilet, overdreven avvisning sammen med skade, og kjente mangler.
- Fastsett terskler for lansering før testing, etter modellen fra Responsible Scaling Policy.
- Test promptinjeksjon gjennom hver kanal en agent leser, ikke bare brukerinndata.
FireAI University-kurset om rammeverk for KI-sikkerhet og red teaming dekker disse metodene mer i detalj.
Relevans for FireAI
FireAI arbeider på Mac-en, under enhver modell. Regler tillater eller blokkerer en app, eller én destinasjon for den appen, slik at et lokalt KI-verktøy kan begrenses til vertene det trenger. Dette begrenser hvor data kan gå hvis en applikasjon oppfører seg feil. FireAI tester ikke modeller, oppdager ikke promptinjeksjon, leser ikke prompter og filtrerer ikke modellens utdata.
Begrensninger
- Notatet bygger bare på det Anthropic og HackerOne har publisert. Anthropics interne prosesser utover dette er ikke synlige, og publiserte sammendrag er selektive.
- Kildene har ulik dato, fra juli 2023 til juli 2026, og metodene kan ha endret seg siden de eldste innleggene.
- Resultatene som beskrives i et systemkort, er selvrapportert av utvikleren, bortsett fra arbeid som tilskrives navngitte eksterne testere.
- Notatet beskriver én utvikler. Andre leverandører publiserer annet materiale, og sammenligningen med tjenesteeieres praksis er en sammenstilling, ikke et funn fra kildene.
Hvor FireAI og HisnLabs kommer inn
Modelltesting slutter ved API-et. Hva en app eller agent kan nå fra Mac-en, er et separat kontrolltiltak, og det er det FireAI gir.
FireAI er HisnLabs’ eget produkt: en KI-brannmur som kjører direkte på Macen. Den viser hver tilkobling appene dine gjør, i klart språk, og lar deg bestemme hva som forlater Macen din — KI-en kjører lokalt, så trafikken din sendes aldri til oss eller noen andre. HisnLabs’ sikkerhetsforskningsteam er de som holder disse vurderingene pålitelige: de katalogiserer hvilke domener som er vanlig telemetri og hvilke som er en ekte tjeneste, sporer landet og nettverket bak en tilkobling, og trener den lokale modellen (FireAI Pilot-funksjonen) på ekte trafikkmønstre — uten at noe av det forlater Macen din.
Du kan lese om de tekniske valgene bak, eller prøve FireAI i 17 dager, på FireAI, fra HisnLabs.