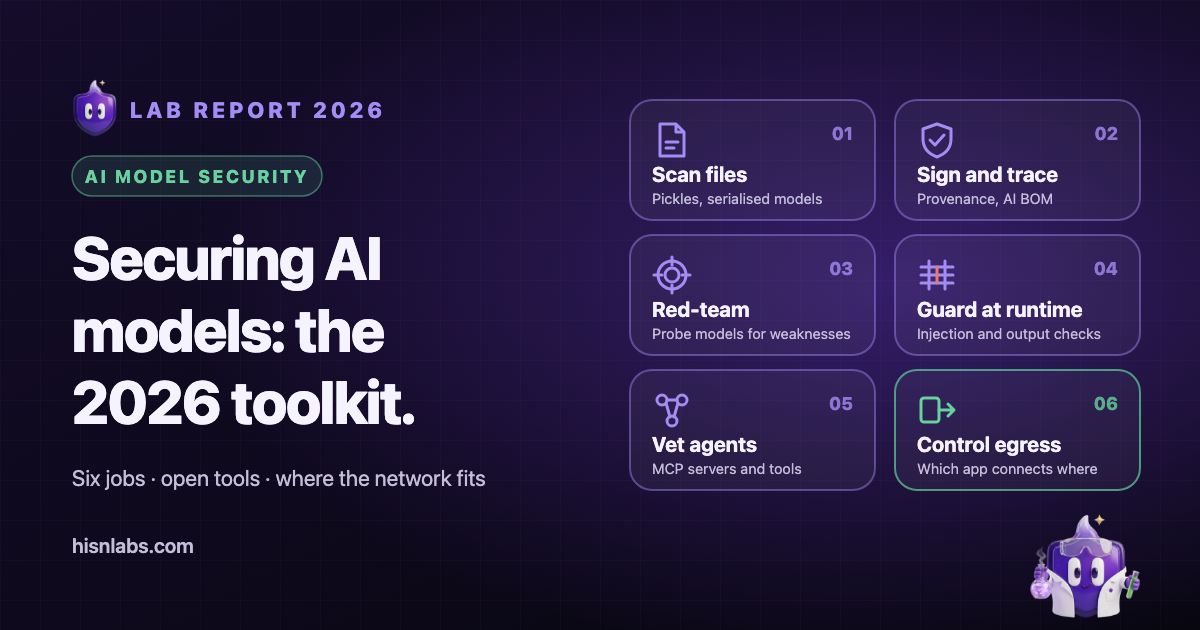
La sicurezza dei modelli di IA non è una sola disciplina ma sei compiti, ciascuno con i propri strumenti: analizzare i file dei modelli, stabilirne la provenienza, sondare un modello alla ricerca di debolezze, proteggerlo in fase di esecuzione, verificare gli strumenti agentici che lo circondano e limitare dove l’applicazione che lo ospita può connettersi. Questa rassegna, preparata da HisnLabs, lo sviluppatore di FireAI, riguarda strumenti aperti i cui repository o la cui documentazione sono stati consultati il 30 settembre 2026. Licenze, manutentori e stato sono riportati come li indicano le fonti primarie, e nessuno strumento è classificato sopra un altro, perché i compiti non sono in concorrenza tra loro.
Ambito e metodo
Ogni strumento è stato incluso solo se era possibile aprirne il repository o la documentazione ufficiale, identificarne la licenza e verificarne lo stato di manutenzione (archiviato o attivo, e la data dell’ultima release quando la pagina delle release la indica). Le release citate di seguito sono le più recenti al momento della consultazione. Nulla di quanto segue è una misura delle prestazioni: le fonti non forniscono risultati di rilevamento confrontabili, e non se ne dichiarano. Le piattaforme commerciali sono escluse, salvo quando l’oggetto è un loro componente aperto.
Le categorie seguono l’ordine in cui un modello attraversa un progetto: un file viene scaricato, se ne verifica l’origine, il modello viene testato, viene messo in produzione dietro delle protezioni, viene collegato agli strumenti e l’applicazione che lo esegue raggiunge la rete. La OWASP Top 10 for Large Language Model Applications, mantenuta all’interno dell’OWASP GenAI Security Project, è il lessico condiviso abituale per i rischi a livello applicativo delle categorie dalla tre alla cinque.
1. Analisi dei file dei modelli
Molti file di modelli sono serializzati con il formato pickle di Python, che può eseguire codice al caricamento. La documentazione di Hugging Face afferma che caricare un pickle “means that code can be executed” e indica gli opcode GLOBAL, STACK_GLOBAL e REDUCE come quelli che costituiscono la minaccia. Hugging Face: Pickle scanning Gli scanner leggono le istruzioni del file senza caricarlo e segnalano le importazioni pericolose.
ModelScan
ModelScan è mantenuto da Protect AI con licenza Apache-2.0. Analizza i formati basati su pickle (PyTorch, scikit-learn, XGBoost, joblib, cloudpickle), TensorFlow SavedModel e i file Keras H5 e V3, classifica i risultati per gravità e termina con codici di uscita adatti alle pipeline di CI. L’ultima release sulla sua pagina è la v0.8.8 del 18 febbraio 2026, e il repository mostrava attività il 28 settembre 2026. Va usato come filtro prima che un modello scaricato entri in una build. Limite: il README descrive un rilevamento basato su firme che può produrre falsi positivi e falsi negativi, e i risultati richiedono una revisione umana.
picklescan
picklescan è uno scanner con licenza MIT mantenuto da un account individuale, mmaitre314. La documentazione di Hugging Face cita picklescan tra gli strumenti sviluppati per l’Hub. L’ultima release è la v1.0.5 del 1 luglio 2026. Analizza file pickle, archivi PyTorch e contenitori ZIP, e può analizzare un percorso locale, un URL o un modello Hugging Face. Va usato per un controllo rapido in uno script. Limite: riconosce le operazioni pericolose per schema, quindi una tecnica nuova può passare, e segnala i risultati senza rimuoverli.
fickling
fickling, di Trail of Bits, è distribuito con licenza LGPL-3.0. È descritto come decompilatore, analizzatore statico e riscrittore di bytecode per pickle. Può decompilare un pickle in Python leggibile, verificarne la sicurezza tramite analisi statica e generare un errore prima del caricamento di un file non sicuro. L’ultima release è la v0.1.12 del 26 giugno 2026. Va usato quando un risultato deve essere compreso, non solo segnalato. Limite: è uno strumento di analisi per pickle e non copre gli altri formati letti da ModelScan. I termini della sua licenza differiscono dalle licenze permissive degli altri scanner.
Analisi dell’Hub di Hugging Face e safetensors
L’Hub analizza ogni file caricato con ClamAV e con una scansione delle importazioni pickle che elenca le importazioni presenti in ciascun file serializzato ed evidenzia quelle sospette. Hugging Face: file scanning Mostra inoltre, sui repository pubblici, i risultati di uno scanner di terze parti, Guardian di Protect AI. Hugging Face: Protect AI Limite, come lo dichiara Hugging Face: la scansione dei pickle non è del tutto infallibile, i suoi elenchi sono mantenuti al meglio delle possibilità e spetta all’utente verificare che cosa sia sicuro. L’alternativa strutturale è safetensors, un formato Apache-2.0 mantenuto da Hugging Face che memorizza i tensori senza contenuto eseguibile. Elimina il rischio pickle per i pesi, ma non dice se i pesi stessi siano affidabili.
2. Provenienza, firma e fingerprinting dei modelli
L’analisi chiede se un file è pericoloso da caricare. La provenienza chiede chi lo ha prodotto e se è cambiato da allora. Le due domande richiedono strumenti diversi.
Sigstore model-transparency
model-transparency è un progetto Apache-2.0 dell’organizzazione Sigstore che firma e verifica modelli di machine learning. Può firmare tramite Sigstore oppure con chiavi, certificati o dispositivi PKCS #11, e produce un bundle contenente una busta DSSE con una dichiarazione in-toto. L’ultima release è la v1.1.1 del 10 ottobre 2025, con commit a settembre 2026. Va usato per permettere a chi riceve i file di verificare che siano quelli firmati dall’editore. Limiti: la documentazione dichiara il supporto per l’hashing di file e frammenti di file, non di singoli tensori, e una firma valida prova origine e integrità, non che il modello sia sicuro. Hugging Face fa la stessa distinzione per i commit firmati, che garantiscono “the origin of the file” e non che il file sia sicuro.
Distinte base per IA e ML
CycloneDX, mantenuto dalla OWASP Foundation e dal TC54 di Ecma International, elenca una Machine Learning Bill of Materials (ML-BOM) tra i tipi di BOM supportati. L’ultima release, la 1.7, è stata pubblicata il 21 ottobre 2025, e i suoi schemi sono Apache-2.0. Il profilo IA di SPDX 3.0 documenta componenti di IA come modelli, dataset e prompt in un unico registro collegato. Entrambi servono a tenere un inventario di quali modelli, dataset e versioni contiene un prodotto, che è la prima cosa di cui ha bisogno una risposta agli incidenti. Limite: una BOM registra ciò che un autore dichiara. Nessuno dei due formati verifica la dichiarazione.
Strumenti di ricerca per fingerprinting e watermarking
Instructional Fingerprinting è il codice di un articolo accademico (arXiv 2401.12255) che inserisce un’impronta in un modello linguistico, così che il proprietario possa in seguito verificare se un altro modello ne deriva. È codice di ricerca con licenza MIT, e l’ultimo aggiornamento del repository risale a luglio 2024. MarkLLM, del gruppo THU-BPM, è un toolkit Apache-2.0 per apporre una filigrana al testo generato da un LLM, presentato come demo a EMNLP 2024. I due rispondono a domande diverse: il primo marca un modello, il secondo il suo output. Vanno usati per studiare l’attribuzione, non come controllo in produzione. Limite: entrambi sono artefatti di ricerca, e nessuno dei due sostituisce la firma di un file distribuito.
3. Red teaming e scansione delle vulnerabilità degli LLM
Questi strumenti inviano input avversariali a un modello o a un’applicazione e registrano come risponde. Verificano il comportamento, non i file.
garak
garak è uno scanner di vulnerabilità per LLM con licenza Apache-2.0 mantenuto da NVIDIA. Il suo README dice che verifica “if an LLM can be made to fail in a way we don’t want”, con sonde per prompt injection, fuga di dati, allucinazioni, tossicità e jailbreak, ciascuna abbinata a un rilevatore. L’ultima release è la v0.17.0 del 9 settembre 2026. Va usato come scansione di base ad ampio raggio di un endpoint di modello. Limiti: richiede accesso API o un’installazione locale del bersaglio, alcune sonde sono onerose in termini di risorse e il README segnala un supporto limitato per i modelli visivi e lo stato di prototipo di alcune sonde.
PyRIT
PyRIT è un framework con licenza MIT descritto come pensato per professionisti della sicurezza e ingegneri che devono identificare i rischi nei sistemi di IA generativa. È mantenuto da Microsoft, e l’ultima release è la v1.1.0 del 4 settembre 2026. Il precedente repository nell’organizzazione Azure è stato archiviato il 27 marzo 2026 con un rimando a quello di Microsoft, quindi i link al vecchio indirizzo portano a una copia in sola lettura. Va usato per campagne di red teaming scriptate e a più turni da parte di un team disposto a scrivere codice. Limite: è un framework, non uno scanner a comando singolo.
promptfoo
promptfoo è uno strumento a riga di comando e una libreria con licenza MIT per valutare applicazioni LLM e per red teaming e scansione delle vulnerabilità, con integrazione CI. L’ultima release è la 0.123.1 del 18 settembre 2026. Il suo README afferma: “Promptfoo is now part of OpenAI. Promptfoo remains open source and MIT licensed.” Va usato per inserire test sui prompt e controlli avversariali in una build. Limite: i risultati dipendono dal fornitore e dal giudice configurati, e la maggior parte dei fornitori richiede chiavi API. Il cambio di proprietà è un fatto di governance da considerare quando si sceglie uno strumento per attività regolamentate.
Giskard
Giskard è una libreria Python Apache-2.0 dell’organizzazione Giskard-AI. La sua versione 3 ha due componenti descritti come stabili: giskard-checks, un framework di test basato su scenari e valutazioni LLM-as-judge, e giskard-scan, uno scanner per le vulnerabilità degli agenti. Va usato per testare agenti e sistemi con retrieval-augmented generation. Limiti: la versione 3 richiede Python 3.12 o successivo, e la versione 2, che copriva l’analisi di modelli tabellari e di machine learning classico, non è più mantenuta attivamente.
4. Protezioni in fase di esecuzione e rilevamento della prompt injection
Le protezioni (guardrail) si collocano nel percorso delle richieste e classificano o vincolano input e output mentre l’applicazione è in esecuzione.
Llama Guard, Prompt Guard e LlamaFirewall
Il progetto Purple Llama di Meta raccoglie misure di protezione per i modelli aperti. Llama Guard è una famiglia di modelli di moderazione di input e output. Prompt Guard 2 è descritto come un classificatore leggero per i tentativi diretti di prompt injection, e LlamaFirewall lo combina con uno scanner di verifica dell’allineamento e uno scanner di codice per gli agenti. Secondo la tabella delle licenze del progetto, i modelli sono distribuiti con le Llama Community Licences, mentre altri componenti, come Code Shield e le valutazioni, sono MIT. Su Hugging Face l’accesso ai modelli è soggetto ad approvazione. Vanno usati dove un piccolo classificatore davanti a un modello è accettabile. Limiti: un classificatore riduce i tentativi che somigliano a schemi noti, ma non elimina la classe di attacco.
NeMo Guardrails
NeMo Guardrails è un toolkit Apache-2.0 di NVIDIA per aggiungere vincoli programmabili alle applicazioni LLM, che usa un linguaggio di modellazione chiamato Colang per controllare il flusso del dialogo. L’ultima release è la v0.24.1 del 16 settembre 2026. Va usato per vincolare argomenti, formati e percorsi di dialogo. Limite: i vincoli sono politiche scritte dallo sviluppatore, quindi la loro copertura è ampia solo quanto ciò che è stato previsto.
Rebuff e LLM Guard, ora archiviati
Rebuff, un rilevatore di prompt injection auto-rafforzante con euristiche, un controllo tramite LLM, un archivio vettoriale degli attacchi passati e token canary, è stato archiviato il 16 maggio 2025. Il suo README afferma che si tratta di un prototipo e che non può fornire una protezione completa contro la prompt injection. LLM Guard, un toolkit con licenza MIT di scanner di input e output dello stesso manutentore, è stato archiviato a luglio 2026. Entrambi restano consultabili come riferimento. Illustrano un punto pratico: i progetti di rilevamento possono perdere i loro manutentori, quindi una protezione dovrebbe essere sostituibile.
5. Scanner di sicurezza per agenti e MCP
Gli agenti aggiungono strumenti, e le descrizioni degli strumenti sono testo che il modello legge. Gli scanner di questo gruppo esaminano tali strumenti e la loro configurazione.
Snyk Agent Scan
Agent Scan, in precedenza MCP-Scan, è uno scanner Apache-2.0 mantenuto da Snyk. Individua i componenti agentici presenti su una macchina, inclusi server MCP e skill in client come Claude, Cursor, VS Code e GitHub Copilot, e li verifica rispetto a prompt injection, avvelenamento degli strumenti e problemi correlati. L’ultima release è la v0.6.8 del 29 settembre 2026. Va usato per verificare che cosa è installato sulla macchina di uno sviluppatore. Limiti: il README afferma che al momento non accetta contributi esterni e che esistono due linee di release con formati di output diversi.
Cisco MCP Scanner
MCP Scanner è uno strumento Apache-2.0 di Cisco AI Defense. Analizza strumenti, prompt, risorse e dipendenze MCP con tre motori che possono funzionare da soli o insieme: regole YARA, analisi tramite LLM e l’API di Cisco AI Defense. L’ultima release è la 4.8.4 del 28 agosto 2026. Va usato per verificare un server prima di adottarlo. Limite: i motori LLM e API richiedono credenziali esterne, e l’analisi della descrizione di un server dice poco su che cosa fa il suo codice dopo un aggiornamento.
6. Il ruolo dei controlli di rete
Gli strumenti descritti sopra esaminano file, modelli, prompt e configurazioni. Nessuno di essi decide quale applicazione può aprire una connessione verso quale server. Questo è il ruolo del controllo del traffico in uscita, ed è importante perché i rischi delle sezioni precedenti convergono sulla rete: un runtime di modello manomesso, uno strumento avvelenato o un agente soggetto a injection deve raggiungere una destinazione per esfiltrare dati o ricevere istruzioni.
FireAI, sviluppato da HisnLabs, è un firewall per il traffico in uscita su macOS. Funziona come filtro di contenuti Network Extension di Apple, identifica ogni app tramite la sua firma del codice e può consentire, bloccare o chiedere per ogni destinazione, con regole per app, dominio o indirizzo. Applicato al lavoro con l’IA su un Mac, ciò significa che un server di inferenza, un agente di programmazione o un client MCP può essere limitato alle destinazioni di cui il suo compito ha bisogno, e che una nuova destinazione richiede una decisione. La documentazione del filtro descrive ciò che FireAI vede: identità dell’app, host o indirizzo remoto, porta e protocollo.
FireAI non analizza i file dei modelli, non verifica le firme, non esegue red teaming su un modello e non classifica i prompt. Non legge il contenuto delle connessioni cifrate, quindi non può distinguere una richiesta legittima da una soggetta a injection quando entrambe vanno verso una destinazione consentita. Integra gli strumenti descritti sopra e non sostituisce nessuno di essi.
Confronto
| Strumento | Compito | Manutentore | Licenza | Stato al 30 set 2026 |
|---|---|---|---|---|
| ModelScan | Analisi dei file dei modelli | Protect AI | Apache-2.0 | Attivo, v0.8.8 |
| picklescan | Analisi dei pickle | mmaitre314 | MIT | Attivo, v1.0.5 |
| fickling | Analisi approfondita dei pickle | Trail of Bits | LGPL-3.0 | Attivo, v0.1.12 |
| safetensors | Formato sicuro per i pesi | Hugging Face | Apache-2.0 | Attivo |
| model-transparency | Firma dei modelli | Sigstore | Apache-2.0 | Attivo, v1.1.1 |
| CycloneDX | Specifica ML-BOM | OWASP, Ecma TC54 | Apache-2.0 (schemi) | Attivo, 1.7 |
| Instructional Fingerprinting | Impronta del modello (ricerca) | Autori dell’articolo | MIT | Ultimo aggiornamento luglio 2024 |
| MarkLLM | Filigrana del testo (ricerca) | THU-BPM | Apache-2.0 | Attivo |
| garak | Scansione delle vulnerabilità | NVIDIA | Apache-2.0 | Attivo, v0.17.0 |
| PyRIT | Framework di red teaming | Microsoft | MIT | Attivo, v1.1.0 |
| promptfoo | Valutazioni e red teaming | Promptfoo, parte di OpenAI | MIT | Attivo, 0.123.1 |
| Giskard v3 | Test e scansione degli agenti | Giskard-AI | Apache-2.0 | Attivo; v2 non mantenuta |
| Llama Guard, Prompt Guard | Modelli di protezione | Meta | Llama Community Licences | Modelli datati aprile 2025 |
| NeMo Guardrails | Vincoli programmabili | NVIDIA | Apache-2.0 | Attivo, v0.24.1 |
| Rebuff, LLM Guard | Rilevamento delle injection | Protect AI | Apache-2.0, MIT | Archiviati |
| Agent Scan | Scansione di agenti e MCP | Snyk | Apache-2.0 | Attivo, v0.6.8 |
| MCP Scanner | Scansione dei server MCP | Cisco AI Defense | Apache-2.0 | Attivo, 4.8.4 |
| FireAI | Controllo del traffico in uscita per app su macOS | HisnLabs | Commerciale | Non analizza i modelli |
Limiti
- Nessuno strumento copre da solo i sei compiti. Un’analisi pulita di un file non dice nulla sul comportamento di un modello, una firma non dice nulla sulla sicurezza e una scansione di red teaming non dice nulla sul contenuto di un file.
- Scanner e protezioni sono rilevatori. Possono non cogliere tecniche nuove, come riconosce ciascuna delle documentazioni di ModelScan, picklescan e Rebuff, e la loro copertura cambia con il cambiare degli attacchi.
- La manutenzione è disomogenea. Due progetti di rilevamento elencati qui sono archiviati, uno strumento ha cambiato proprietario, uno ha un manutentore individuale e un repository di ricerca non cambia dal 2024. Verificare lo stato di un progetto prima di basarvisi.
- Questa rassegna si è limitata a strumenti aperti con fonti primarie consultabili. Esclude le piattaforme commerciali e non confronta i risultati di rilevamento, perché le fonti non forniscono dati confrontabili.
- Le licenze sono state lette dalle pagine dei repository e dalle tabelle delle licenze. Vanno verificate prima di qualsiasi ridistribuzione, in particolare le Llama Community Licences e i termini LGPL di fickling.
- Il livello di rete vede le connessioni, non il significato. Una destinazione consentita può comunque ricevere dati da un runtime di modello compromesso.
Il ruolo di FireAI e di HisnLabs
Analizza il modello, firma il modello, testa il modello. Poi decidi dove può connettersi la sua app.
FireAI è il prodotto di HisnLabs: un firewall con IA che funziona direttamente sul Mac. Mostra in linguaggio chiaro ogni connessione che le tue app effettuano e ti lascia decidere cosa esce dal tuo Mac — la sua IA lavora in locale, quindi il tuo traffico non viene mai inviato a noi né a nessun altro. Il team di ricerca sulla sicurezza di HisnLabs è quello che mantiene affidabili queste decisioni: cataloga quali domini sono semplice telemetria e quali un servizio reale, traccia il Paese e la rete dietro una connessione e addestra il modello locale (la funzione FireAI Pilot) su schemi di traffico reali, senza che nulla lasci il tuo Mac.
Puoi leggere le scelte tecniche che ci stanno dietro, oppure provare FireAI per 17 giorni, su FireAI, di HisnLabs.