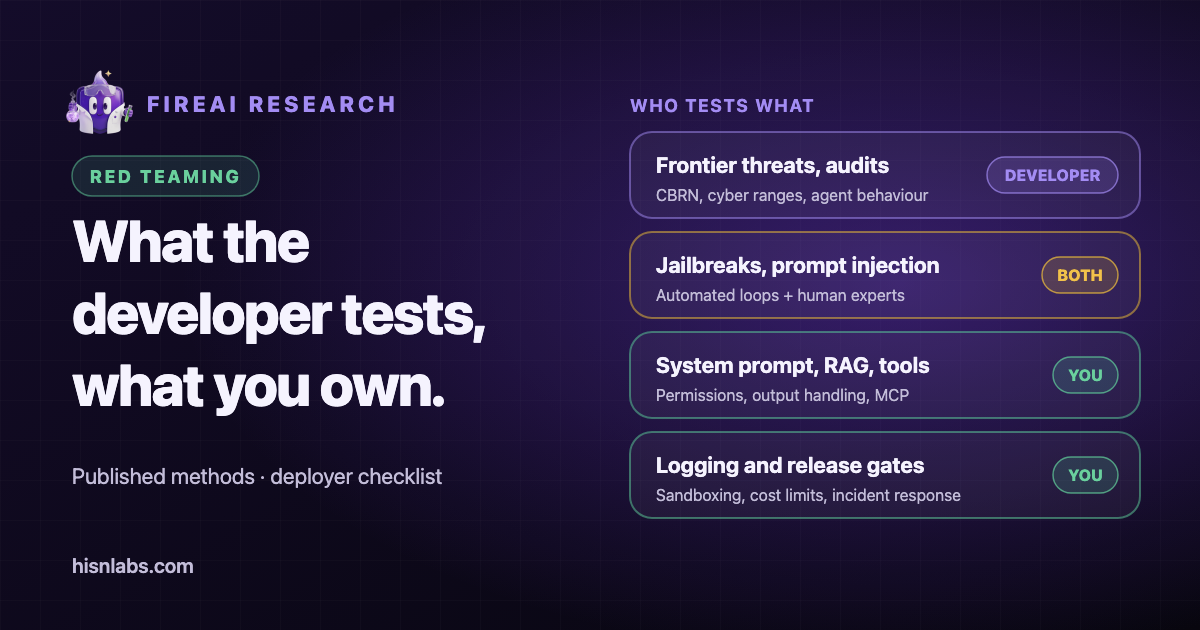
Anthropic pubblica sul modo in cui testa Claude più di quanto facciano la maggior parte degli sviluppatori di modelli: articoli sul red teaming, una Responsible Scaling Policy e una system card per ciascun modello. Questa nota riassume tali documenti e distingue tre gruppi di attività: metodi usati sia dagli sviluppatori sia da chi distribuisce il modello, attività che solo uno sviluppatore può svolgere e attività che restano all’organizzazione che costruisce un’applicazione sul modello. I processi interni che vanno oltre quanto Anthropic ha pubblicato non sono visibili ai lettori esterni e non sono descritti qui. La nota è la seconda metà di una coppia con Shared responsibility for LLMs: who secures what.
Contesto: due domande diverse
Uno sviluppatore di modelli si chiede se un modello sia pericoloso: se possa fornire un aiuto significativo allo sviluppo di armi, condurre operazioni informatiche o comportarsi in modo ingannevole. Chi distribuisce il modello si chiede se la propria applicazione sia sicura: se un documento costruito ad arte, il risultato di uno strumento o un messaggio dell’utente possano indurre l’applicazione a divulgare dati o a compiere un’azione che non dovrebbe. I metodi si sovrappongono, ma le domande e le prove differiscono, e un esito positivo sulla prima domanda non risponde alla seconda.
Che cosa descrive Anthropic
Metodi che si sovrappongono alla pratica di chi distribuisce il modello
In un articolo del 12 giugno 2024, Anthropic raggruppa il proprio red teaming in test condotti da esperti di dominio, test che usano modelli linguistici, lavoro su nuove modalità e approcci aperti. Il red teaming automatizzato usa una dinamica tra red team e blue team in cui un modello genera gli attacchi. Il red teaming multimodale ha coperto i rischi legati a immagini e testo nei modelli Claude 3 prima della distribuzione. I test multilingue hanno incluso una collaborazione con l’Infocomm Media Development Authority di Singapore in quattro lingue: inglese, tamil, mandarino e malese. Anthropic cita anche il red teaming in crowdsourcing e comunitario, compresi eventi presso l’AI Village del DEF CON. [1]
La system card di Claude Opus 5, datata 24 luglio 2026, mostra gli stessi metodi applicati a una singola versione. Il capitolo sulle misure di salvaguardia usa richieste dannose e innocue a turno singolo, prompt con contesto ambiguo e conversazioni a più turni in cui un utente simulato si sposta gradualmente verso il danno. Riporta l’innocuità insieme al rifiuto eccessivo, affermando che il modello ha mantenuto alti tassi di risposte innocue alle richieste dannose e, al tempo stesso, tassi di rifiuto eccessivo tra i più bassi sulle richieste innocue. Il capitolo sulla sicurezza agentica copre l’uso malevolo di agenti di programmazione e di uso del computer e la robustezza alla prompt injection nella programmazione, nell’uso del computer e nell’uso del browser. [7]
La system card definisce la prompt injection come un’istruzione malevola nascosta nei risultati degli strumenti che un agente elabora, e osserva che il rischio è massimo quando un agente può sia raggiungere dati privati sia agire per conto di un utente. Riporta inoltre che le istruzioni di sicurezza nel prompt di sistema su claude.ai hanno rafforzato la gestione delle richieste dannose da parte del modello rispetto all’API senza prompt di sistema. [7] Il secondo risultato riguarda direttamente chi distribuisce il modello, perché il prompt di sistema fa parte della sua competenza.
La Responsible Scaling Policy, versione 3.4, in vigore dall’8 luglio 2026, fissa in anticipo le soglie di capacità e richiede valutazioni formali a intervalli di sei mesi, e prevede revisori esterni per i rapporti sui rischi. [4] Fissare le soglie prima dei test limita la tentazione di reinterpretare un risultato a posteriori, e la pratica è trasferibile a qualsiasi organizzazione che definisca criteri di rilascio.
Attività che solo uno sviluppatore di modelli può svolgere
Il red teaming sulle minacce di frontiera riguarda i rischi chimici, biologici, radiologici e nucleari (CBRN), la cybersicurezza e i rischi legati all’IA autonoma. Un articolo del 2023 descrive esperti di dominio con decenni di esperienza che definiscono i modelli di minaccia, oltre 100 ore di indagine da parte di esperti e uno studio di biosicurezza di sei mesi per oltre 150 ore. [3] Un articolo di marzo 2025 descrive valutazioni informatiche basate su sfide capture-the-flag e ambienti di rete simulati, e afferma che il Frontier Red Team ha collaborato con l’US AI Safety Institute, l’UK AI Security Institute e la US National Nuclear Security Administration (NNSA), quest’ultima su valutazioni classificate delle conoscenze nucleari e radiologiche. [2]
Il Transparency Hub di Anthropic afferma che l’azienda usa red teaming sia interno sia esterno e che l’UK AI Security Institute, il US Center for AI Standards and Innovation e Model Evaluation and Threat Research (METR) hanno svolto test aggiuntivi sui suoi modelli. Elenca inoltre programmi di bug bounty su HackerOne. [5] La system card di Opus 5 include test in cyber range dell’UK AI Security Institute e una valutazione dell’allineamento basata su un audit comportamentale automatizzato, oltre a un capitolo sul benessere del modello. [7] La pagina del Transparency Hub non indica quale istituto abbia testato un dato modello prima del rilascio, quindi il ruolo di ciascuno prima della distribuzione non è stabilito qui oltre quanto riportato nella system card.
I test esterni e in crowdsourcing costituiscono una categoria distinta. HackerOne riferisce che la sfida di jailbreak di Anthropic si è svolta dal 3 al 10 febbraio 2025 con 339 partecipanti, oltre 300,000 interazioni in chat e otto livelli di difficoltà, e che quattro team si sono divisi 55,000 dollari statunitensi in ricompense. Le tecniche riuscite includevano prompt codificati e cifrari, gioco di ruolo, sostituzione di parole chiave dannose con parole innocue e prompt injection. [6] Per Opus 5, la system card cita tre tester esterni a contratto: uno ha impiegato circa 100 ore e ha completato un compito con prompt specifici per il compito, uno ha impiegato circa 16 ore senza un jailbreak riuscito e uno ha eseguito un attaccante automatizzato con 150 tentativi per compito senza successo. [7]
Che cosa resta a chi distribuisce il modello
Nessuno dei test dello sviluppatore descritti sopra valuta un’applicazione specifica. Gli elementi seguenti restano all’organizzazione che distribuisce il modello, e la system card stessa ne indica diversi, per esempio mostrando che i prompt di sistema modificano il comportamento del modello e che gli agenti sono più esposti quando combinano dati privati con la capacità di agire. [7]
- Il prompt di sistema e le sue protezioni, compreso il loro comportamento sotto pressione su più turni.
- Dati RAG e prompt injection indiretta: qualsiasi documento, pagina o email recuperato nel contesto può contenere istruzioni.
- Strumenti, permessi dell’agente e ciò che un’istruzione iniettata potrebbe farne.
- La gestione a valle dell’output del modello prima che raggiunga un browser, una shell, un database o una persona.
- La catena di fornitura, compresi plugin di terze parti e server Model Context Protocol (MCP).
- L’abuso dei costi, come cicli senza limiti o richieste che consumano token a pagamento.
- Il sandboxing dell’esecuzione di codice e della navigazione, e il controllo dell’accesso di rete in uscita.
- Registrazione, monitoraggio e soglie di rilascio che stabiliscono quando una modifica può essere pubblicata.
Pratiche da adottare
- Incaricare red teamer esterni, o avviare un bug bounty privato, prima delle versioni principali. La pratica di Anthropic include entrambi: tester esterni a contratto per ogni versione e una sfida pubblica di jailbreak con ricompense.
- Eseguire sugli agenti una verifica del comportamento in stile allineamento: campionare trascrizioni dell’uso degli strumenti e cercare tentativi di aggirare le restrizioni, come ha fatto il monitoraggio di Anthropic per la distribuzione interna.
- Redigere una breve system card interna per ogni versione: che cosa è stato testato, quali test sono falliti, il rifiuto eccessivo accanto al danno e le lacune note.
- Fissare le soglie di rilascio prima dei test, seguendo l’approccio della Responsible Scaling Policy.
- Testare la prompt injection attraverso ogni canale che un agente legge, non solo l’input dell’utente.
Il corso della FireAI University su framework di sicurezza dell’IA e red teaming tratta questi metodi in modo più approfondito.
Rilevanza per FireAI
FireAI opera sul Mac, al di sotto di qualsiasi modello. Le Regole consentono o bloccano un’app, o una singola destinazione per quell’app, così che uno strumento di IA locale possa essere limitato agli host di cui ha bisogno. Questo limita dove possono finire i dati se un’applicazione si comporta in modo scorretto. FireAI non testa modelli, non rileva la prompt injection, non legge i prompt e non filtra l’output dei modelli.
Limiti
- La nota si basa solo su quanto pubblicato da Anthropic e HackerOne. I processi interni di Anthropic al di là di ciò non sono visibili, e i riepiloghi pubblicati sono selettivi.
- Le fonti hanno date diverse, da luglio 2023 a luglio 2026, e i metodi potrebbero essere cambiati rispetto agli articoli più vecchi.
- I risultati descritti in una system card sono dichiarati dallo sviluppatore stesso, a eccezione del lavoro attribuito a tester esterni nominati.
- La nota descrive un solo sviluppatore. Altri fornitori pubblicano materiale diverso, e il confronto con la pratica di chi distribuisce il modello è una sintesi, non un risultato tratto dalle fonti.
Il ruolo di FireAI e di HisnLabs
I test del modello finiscono all’API. Ciò che un’app o un agente può raggiungere dal tuo Mac è un controllo separato, e FireAI lo fornisce.
FireAI è il prodotto di HisnLabs: un firewall con IA che funziona direttamente sul Mac. Mostra in linguaggio chiaro ogni connessione che le tue app effettuano e ti lascia decidere cosa esce dal tuo Mac — la sua IA lavora in locale, quindi il tuo traffico non viene mai inviato a noi né a nessun altro. Il team di ricerca sulla sicurezza di HisnLabs è quello che mantiene affidabili queste decisioni: cataloga quali domini sono semplice telemetria e quali un servizio reale, traccia il Paese e la rete dietro una connessione e addestra il modello locale (la funzione FireAI Pilot) su schemi di traffico reali, senza che nulla lasci il tuo Mac.
Puoi leggere le scelte tecniche che ci stanno dietro, oppure provare FireAI per 17 giorni, su FireAI, di HisnLabs.