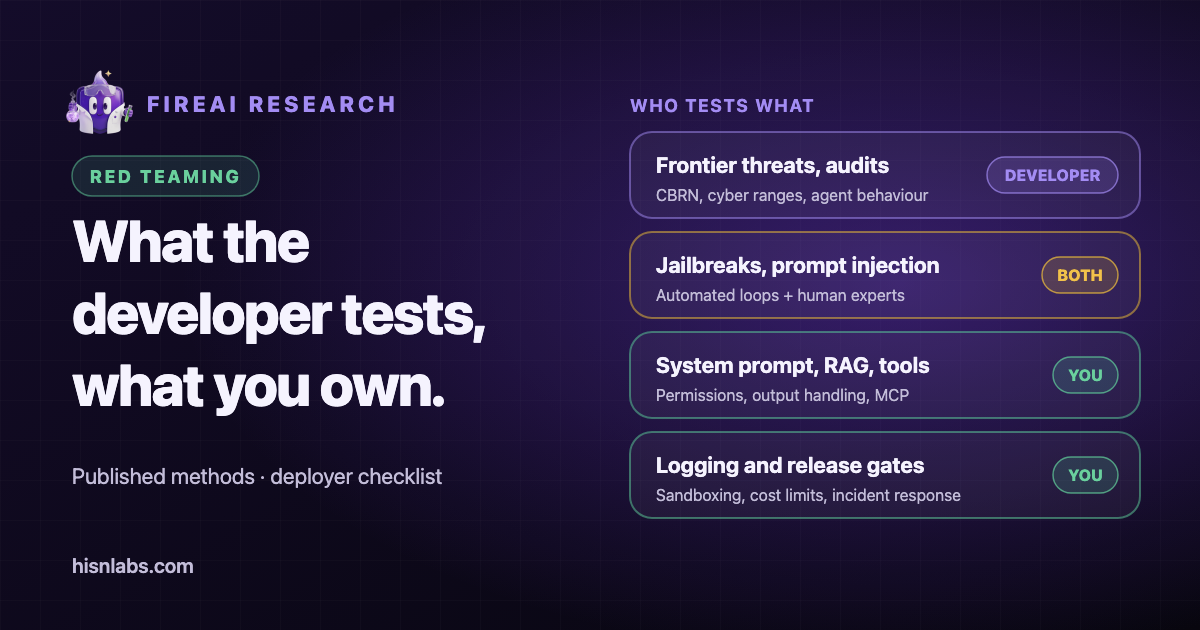
Anthropic publie davantage sur la manière dont elle teste Claude que la plupart des développeurs de modèles : des billets sur le red teaming, une Responsible Scaling Policy et une fiche système (system card) pour chaque modèle. Cette note résume ces documents et distingue trois ensembles de travaux : les méthodes qu’emploient à la fois développeurs et déployeurs, le travail que seul un développeur peut accomplir, et celui qui revient à l’organisation qui construit une application sur le modèle. Les processus internes qui dépassent ce qu’Anthropic a publié ne sont pas visibles des lecteurs extérieurs et ne sont pas décrits ici. Cette note forme la seconde moitié d’un diptyque avec Responsabilité partagée pour les LLM : qui sécurise quoi.
Contexte : deux questions différentes
Un développeur de modèle se demande si un modèle est dangereux : s’il peut apporter un gain significatif au développement d’armes, mener des opérations cyber ou se comporter de manière trompeuse. Un déployeur se demande si son application est sûre : si un document, un résultat d’outil ou un message utilisateur conçu à cet effet peut amener l’application à divulguer des données ou à accomplir une action qu’elle ne devrait pas accomplir. Les méthodes se recoupent, mais les questions et les éléments de preuve diffèrent, et un résultat satisfaisant à la première question ne répond pas à la seconde.
Ce que décrit Anthropic
Les méthodes communes avec la pratique des déployeurs
Dans un billet du 12 juin 2024, Anthropic regroupe son red teaming en tests par des experts de domaine, tests faisant appel à des modèles de langage, travaux sur les nouvelles modalités et approches ouvertes. Le red teaming automatisé repose sur une dynamique équipe rouge contre équipe bleue dans laquelle un modèle génère les attaques. Le red teaming multimodal a couvert les risques liés à l’image et au texte des modèles Claude 3 avant leur déploiement. Les tests multilingues ont inclus un partenariat avec l’Infocomm Media Development Authority de Singapour portant sur quatre langues : l’anglais, le tamoul, le mandarin et le malais. Anthropic mentionne également le red teaming participatif et communautaire, notamment lors d’événements de l’AI Village de la DEF CON. [1]
La fiche système de Claude Opus 5, datée du 24 juillet 2026, montre ces mêmes méthodes appliquées à une version donnée. Son chapitre consacré aux garde-fous utilise des requêtes nuisibles et anodines en un seul tour, des invites au contexte ambigu et des conversations à plusieurs tours dans lesquelles un utilisateur simulé oriente progressivement l’échange vers un préjudice. Elle présente l’innocuité conjointement avec le refus excessif, en indiquant que le modèle a maintenu des taux élevés de réponses inoffensives aux requêtes nuisibles tout en conservant l’un des plus faibles taux de refus excessif sur les requêtes anodines. Son chapitre sur la sécurité agentique traite de l’usage malveillant des agents de code et d’utilisation de l’ordinateur, ainsi que de la robustesse face à l’injection de prompt dans le code, l’utilisation de l’ordinateur et la navigation web. [7]
La fiche système définit l’injection de prompt comme une instruction malveillante dissimulée dans les résultats d’outils qu’un agent traite, et relève que le risque est maximal lorsqu’un agent peut à la fois accéder à des données privées et agir au nom d’un utilisateur. Elle indique aussi que les consignes de sécurité du prompt système de claude.ai ont renforcé la façon dont le modèle traite les requêtes nuisibles, par rapport à l’API sans prompt système. [7] Ce second constat concerne directement les déployeurs, car le prompt système relève de leur responsabilité.
La Responsible Scaling Policy, version 3.4, en vigueur depuis le 8 juillet 2026, fixe à l’avance des seuils de capacité, impose des évaluations formelles à intervalles de six mois et prévoit des relecteurs externes pour les rapports de risque. [4] Fixer les seuils avant les tests limite la tentation de réinterpréter un résultat après coup, et cette pratique est transposable à toute organisation qui définit des critères de mise en production.
Le travail que seul un développeur de modèle peut accomplir
Le red teaming des menaces de frontière vise les risques chimiques, biologiques, radiologiques et nucléaires (CBRN), la cybersécurité et les risques liés à l’IA autonome. Un billet de 2023 décrit des experts de domaine forts de plusieurs décennies d’expérience qui définissent les modèles de menace, plus de 100 heures d’examen par des experts et une étude de biosécurité de six mois totalisant plus de 150 heures. [3] Un billet de mars 2025 décrit des évaluations cyber fondées sur des épreuves de type capture the flag et des environnements réseau simulés, et indique que la Frontier Red Team a travaillé avec l’US AI Safety Institute, l’UK AI Security Institute et la National Nuclear Security Administration (NNSA) des États-Unis, cette dernière sur des évaluations classifiées des connaissances nucléaires et radiologiques. [2]
Le Transparency Hub d’Anthropic indique que l’entreprise recourt à un red teaming interne et externe, et que l’UK AI Security Institute, l’US Center for AI Standards and Innovation et Model Evaluation and Threat Research (METR) ont mené des tests supplémentaires sur ses modèles. Il mentionne aussi des programmes de bug bounty sur HackerOne. [5] La fiche système d’Opus 5 comprend des tests sur cyber range menés par l’UK AI Security Institute et une évaluation de l’alignement fondée sur un audit comportemental automatisé, ainsi qu’un chapitre sur le bien-être du modèle. [7] La page du Transparency Hub ne précise pas quel institut a testé un modèle donné avant sa sortie ; le rôle de chacun avant le déploiement n’est donc pas établi ici au-delà de ce que rapporte la fiche système.
Les tests externes et participatifs constituent une catégorie à part. HackerOne rapporte que le défi de jailbreak d’Anthropic s’est déroulé du 3 au 10 février 2025 avec 339 participants, plus de 300 000 échanges et huit niveaux de difficulté, et que quatre équipes se sont partagé 55 000 dollars américains de primes. Parmi les techniques efficaces figuraient des invites encodées et des chiffrements, le jeu de rôle, la substitution de mots-clés nuisibles par des termes anodins et l’injection de prompt. [6] Pour Opus 5, la fiche système nomme trois testeurs externes sous contrat : l’un a consacré environ 100 heures et réussi une tâche grâce à des invites spécifiques à cette tâche, un autre a passé environ 16 heures sans parvenir à un jailbreak, et le troisième a fait tourner un attaquant automatisé à raison de 150 tentatives par tâche, sans succès. [7]
Ce qui reste à la charge des déployeurs
Aucun des tests menés par le développeur ci-dessus n’évalue une application particulière. Les éléments suivants restent du ressort de l’organisation qui déploie le modèle, et la fiche système en signale elle-même plusieurs, par exemple en montrant que les prompts système modifient le comportement du modèle et que les agents sont les plus exposés lorsqu’ils combinent des données privées et la capacité d’agir. [7]
- Le prompt système et ses garde-fous, y compris leur comportement sous une pression exercée sur plusieurs tours.
- Les données RAG et l’injection de prompt indirecte : tout document, toute page ou tout e-mail récupéré dans le contexte peut contenir des instructions.
- Les outils, les permissions de l’agent et ce qu’une instruction injectée pourrait en faire.
- Le traitement en aval de la sortie du modèle avant qu’elle n’atteigne un navigateur, un shell, une base de données ou une personne.
- La chaîne d’approvisionnement, y compris les plugins tiers et les serveurs Model Context Protocol (MCP).
- L’abus de coûts, comme des boucles sans limite ou des requêtes qui consomment des tokens payants.
- Le cloisonnement de l’exécution de code et de la navigation, et le contrôle de l’accès réseau sortant.
- La journalisation, la surveillance et les points de contrôle qui décident quand une modification peut être publiée.
Des pratiques à reprendre
- Faites appel à des red teamers externes, ou lancez un bug bounty privé, avant les versions majeures. La pratique d’Anthropic comprend les deux : des testeurs externes sous contrat pour chaque version et un défi de jailbreak public assorti de primes.
- Soumettez les agents à un contrôle comportemental inspiré des évaluations d’alignement : échantillonnez des transcriptions d’utilisation d’outils et recherchez les tentatives de contournement des restrictions, comme l’a fait la surveillance d’Anthropic pour son déploiement interne.
- Rédigez pour chaque version une courte fiche système interne : ce qui a été testé, quels tests ont échoué, le refus excessif à côté du préjudice, et les lacunes connues.
- Fixez les seuils de mise en production avant les tests, selon l’approche de la Responsible Scaling Policy.
- Testez l’injection de prompt par chaque canal que lit un agent, et pas seulement par les saisies de l’utilisateur.
Le cours de la FireAI University sur les cadres de sécurité de l’IA et le red teaming présente ces méthodes plus en détail.
Pertinence pour FireAI
FireAI opère sur le Mac, en dessous de tout modèle. Les règles autorisent ou bloquent une app, ou une destination donnée pour cette app, de sorte qu’un outil d’IA local peut être limité aux hôtes dont il a besoin. Cela restreint les destinations possibles des données si une application se comporte mal. FireAI ne teste pas les modèles, ne détecte pas l’injection de prompt, ne lit pas les prompts et ne filtre pas la sortie des modèles.
Limites
- Cette note s’appuie uniquement sur ce qu’Anthropic et HackerOne ont publié. Les processus internes d’Anthropic au-delà de ces publications ne sont pas visibles, et les résumés publiés sont sélectifs.
- Les sources s’échelonnent de juillet 2023 à juillet 2026, et les méthodes ont pu évoluer depuis les billets les plus anciens.
- Les résultats décrits dans une fiche système sont déclarés par le développeur lui-même, à l’exception des travaux attribués à des testeurs externes nommés.
- La note décrit un seul développeur. D’autres fournisseurs publient des documents différents, et la comparaison avec la pratique des déployeurs est une synthèse, non un constat tiré des sources.
Le rôle de FireAI et de HisnLabs
Les tests du modèle s’arrêtent à l’API. Ce qu’une app ou un agent peut atteindre depuis votre Mac relève d’un contrôle distinct, que FireAI assure.
FireAI est le produit de HisnLabs : un pare-feu IA embarqué pour Mac. Il montre en langage clair chaque connexion faite par vos applications et vous laisse décider ce qui sort de votre Mac — son IA fonctionne en local, votre trafic ne nous est jamais envoyé, ni à personne d’autre. L’équipe de recherche en sécurité de HisnLabs est celle qui garde ces décisions fiables : elle recense les domaines de simple télémétrie face à ceux d’un vrai service, suit le pays et le réseau derrière une connexion, et entraîne le modèle embarqué (la fonction FireAI Pilot) sur du trafic réel, sans que rien ne quitte votre Mac.
Vous pouvez lire les choix techniques qui s’y trouvent, ou essayer FireAI pendant 17 jours, sur FireAI, par HisnLabs.