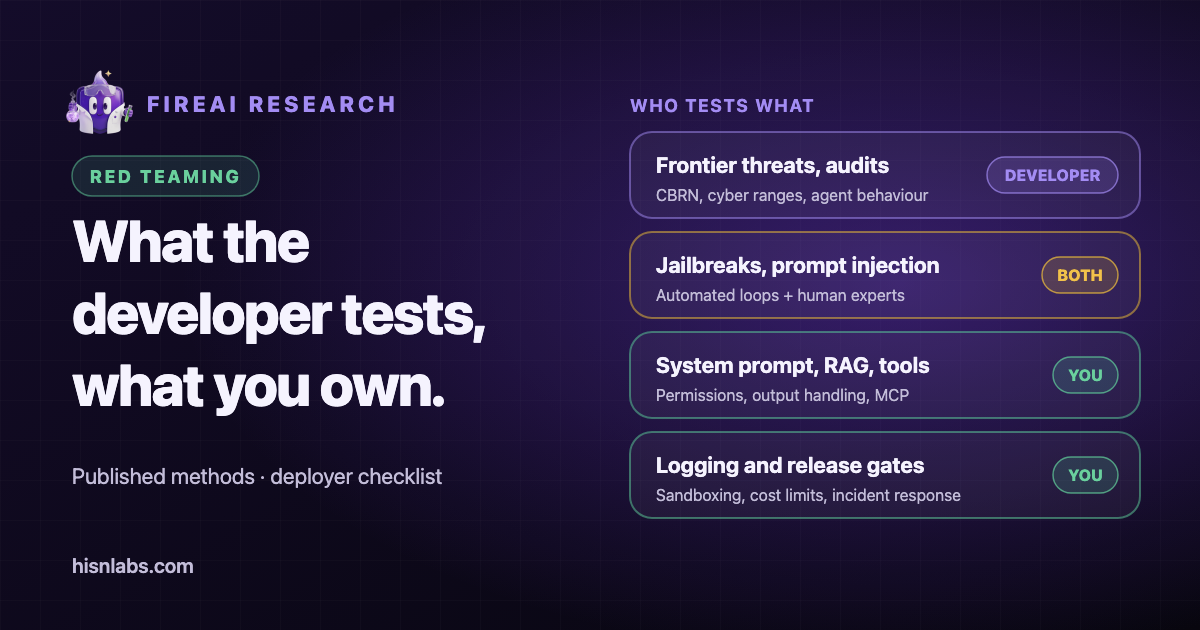
Anthropic publica sobre cómo prueba Claude más que la mayoría de los desarrolladores de modelos: artículos sobre red teaming, una Responsible Scaling Policy y fichas de sistema (system cards) para cada modelo. Esta nota resume esos documentos y distingue tres grupos de trabajo: métodos que utilizan tanto los desarrolladores como quienes despliegan los modelos, trabajo que solo puede hacer un desarrollador y trabajo que corresponde a la organización que construye una aplicación sobre el modelo. Los procesos internos que van más allá de lo publicado por Anthropic no son visibles para un lector externo y no se describen aquí. La nota es la segunda mitad de un par junto con Shared responsibility for LLMs: who secures what.
Contexto: dos preguntas distintas
Un desarrollador de modelos se pregunta si un modelo es peligroso: si puede aportar una ayuda significativa al desarrollo de armas, llevar a cabo operaciones cibernéticas o comportarse de forma engañosa. Quien despliega un modelo se pregunta si su aplicación es segura: si un documento manipulado, el resultado de una herramienta o un mensaje de usuario pueden hacer que la aplicación filtre datos o realice una acción que no debería. Los métodos se solapan, pero las preguntas y las pruebas difieren, y un resultado favorable en la primera pregunta no responde a la segunda.
Lo que describe Anthropic
Métodos que coinciden con la práctica de quien despliega
En un artículo del 12 de junio de 2024, Anthropic agrupa su red teaming en pruebas de expertos de dominio, pruebas que utilizan modelos de lenguaje, trabajo sobre nuevas modalidades y enfoques abiertos. El red teaming automatizado usa una dinámica de equipo rojo y equipo azul en la que un modelo genera los ataques. El red teaming multimodal abarcó los riesgos de imagen y texto de los modelos Claude 3 antes de su despliegue. Las pruebas multilingües incluyeron una colaboración con la Infocomm Media Development Authority de Singapur en cuatro idiomas: inglés, tamil, mandarín y malayo. Anthropic menciona también el red teaming colaborativo y comunitario, incluidos eventos en la AI Village de DEF CON. [1]
La ficha de sistema de Claude Opus 5, fechada el 24 de julio de 2026, muestra esos mismos métodos aplicados a una versión concreta. Su capítulo de salvaguardas utiliza solicitudes dañinas y benignas de un solo turno, prompts de contexto ambiguo y conversaciones de varios turnos en las que un usuario simulado se dirige gradualmente hacia el daño. Informa de la inocuidad junto con el exceso de rechazos, y afirma que el modelo mantuvo altas tasas de respuestas inocuas ante solicitudes dañinas a la vez que se situaba entre las tasas más bajas de rechazo excesivo ante las benignas. Su capítulo de seguridad agéntica abarca el uso malicioso de agentes de programación y de uso del ordenador, así como la robustez frente a la inyección de prompts en programación, uso del ordenador y uso del navegador. [7]
La ficha de sistema define la inyección de prompts como una instrucción maliciosa oculta en los resultados de herramientas que procesa un agente, y señala que el riesgo es máximo cuando un agente puede a la vez acceder a datos privados y actuar en nombre de un usuario. También informa de que las instrucciones de seguridad del prompt de sistema de claude.ai reforzaron el tratamiento de las solicitudes dañinas por parte del modelo en comparación con la API sin prompt de sistema. [7] Esta segunda conclusión afecta directamente a quienes despliegan modelos, porque el prompt de sistema forma parte de su lado.
La Responsible Scaling Policy, versión 3.4, en vigor desde el 8 de julio de 2026, fija de antemano umbrales de capacidad y exige evaluaciones formales cada seis meses, además de prever revisores externos de los informes de riesgo. [4] Fijar los umbrales antes de las pruebas limita la tentación de reinterpretar un resultado a posteriori, y la práctica es trasladable a cualquier organización que defina criterios de publicación.
Trabajo que solo puede hacer un desarrollador de modelos
El red teaming de amenazas de frontera se centra en los riesgos químicos, biológicos, radiológicos y nucleares (QBRN), la ciberseguridad y los riesgos de la IA autónoma. Un artículo de 2023 describe a expertos de dominio con décadas de experiencia que definieron modelos de amenaza, más de 100 horas de sondeo experto y un estudio de bioseguridad de seis meses y más de 150 horas. [3] Un artículo de marzo de 2025 describe evaluaciones cibernéticas basadas en retos capture-the-flag y entornos de red simulados, e indica que el Frontier Red Team trabajó con el US AI Safety Institute, el UK AI Security Institute y la National Nuclear Security Administration (NNSA) de EE. UU., esta última en evaluaciones clasificadas de conocimientos nucleares y radiológicos. [2]
El Transparency Hub de Anthropic indica que la empresa recurre tanto al red teaming interno como al externo y que el UK AI Security Institute, el US Center for AI Standards and Innovation y Model Evaluation and Threat Research (METR) han realizado pruebas adicionales de sus modelos. También enumera programas de recompensas por errores en HackerOne. [5] La ficha de sistema de Opus 5 incluye pruebas en un cyber range del UK AI Security Institute y una evaluación de alineamiento basada en una auditoría de comportamiento automatizada, así como un capítulo sobre el bienestar del modelo. [7] La página del Transparency Hub no indica qué instituto probó un modelo determinado antes de su publicación, por lo que el papel previo al despliegue de cada uno no queda establecido aquí más allá de lo que recoge la ficha de sistema.
Las pruebas externas y colaborativas constituyen una categoría aparte. HackerOne informa de que el reto de jailbreak de Anthropic se desarrolló del 3 al 10 de febrero de 2025 con 339 participantes, más de 300.000 interacciones de chat y ocho niveles de dificultad, y de que cuatro equipos se repartieron 55.000 dólares estadounidenses en recompensas. Entre las técnicas que tuvieron éxito figuraban prompts codificados y cifrados, juegos de rol, la sustitución de palabras clave dañinas por otras benignas y la inyección de prompts. [6] Para Opus 5, la ficha de sistema menciona tres evaluadores externos contratados: uno dedicó unas 100 horas y completó una tarea con prompts específicos para ella, otro dedicó unas 16 horas sin lograr ningún jailbreak y el tercero ejecutó un atacante automatizado con 150 intentos por tarea sin éxito. [7]
Lo que queda en manos de quien despliega
Ninguna de las pruebas del desarrollador descritas evalúa una aplicación concreta. Lo siguiente corresponde a la organización que despliega el modelo, y la propia ficha de sistema apunta a varios de estos puntos, por ejemplo al mostrar que los prompts de sistema cambian el comportamiento del modelo y que los agentes están más expuestos cuando combinan datos privados con la capacidad de actuar. [7]
- El prompt de sistema y sus barreras de protección, incluido su comportamiento bajo presión en varios turnos.
- Los datos de RAG y la inyección indirecta de prompts: cualquier documento, página o correo recuperado en el contexto puede contener instrucciones.
- Las herramientas, los permisos del agente y lo que una instrucción inyectada podría hacer con ellos.
- El tratamiento posterior de la salida del modelo antes de que llegue a un navegador, un shell, una base de datos o una persona.
- La cadena de suministro, incluidos los plugins de terceros y los servidores Model Context Protocol (MCP).
- El abuso de costes, como bucles sin límite o solicitudes que consumen tokens de pago.
- El aislamiento (sandboxing) de la ejecución de código y la navegación, y el control del acceso de red saliente.
- El registro, la monitorización y los controles de publicación que deciden cuándo puede salir un cambio.
Prácticas que vale la pena adoptar
- Encargar pruebas a red teamers externos, o lanzar un programa privado de recompensas por errores, antes de las versiones importantes. La propia práctica de Anthropic incluye ambas cosas: evaluadores externos contratados para cada versión y un reto público de jailbreak con recompensas.
- Realizar en los agentes una comprobación de comportamiento al estilo de las de alineamiento: tomar muestras de transcripciones de uso de herramientas y buscar intentos de eludir restricciones, como hizo la monitorización de Anthropic en el despliegue interno.
- Redactar una breve ficha de sistema interna para cada versión: qué se probó, qué pruebas fallaron, el exceso de rechazos junto al daño y las carencias conocidas.
- Fijar los umbrales de publicación antes de las pruebas, siguiendo el enfoque de la Responsible Scaling Policy.
- Probar la inyección de prompts a través de todos los canales que lee un agente, no solo la entrada del usuario.
El curso de FireAI University sobre marcos de seguridad de la IA y red teaming trata estos métodos con más detalle.
Relación con FireAI
FireAI funciona en el Mac, por debajo de cualquier modelo. Las reglas permiten o bloquean una app, o un destino concreto de esa app, de modo que una herramienta de IA local puede limitarse a los hosts que necesita. Esto restringe a dónde pueden ir los datos si una aplicación se comporta de forma indebida. FireAI no prueba modelos, no detecta la inyección de prompts, no lee prompts ni filtra la salida de los modelos.
Limitaciones
- La nota se basa únicamente en lo que han publicado Anthropic y HackerOne. Los procesos internos de Anthropic que van más allá no son visibles, y los resúmenes publicados son selectivos.
- Las fuentes tienen fechas distintas, de julio de 2023 a julio de 2026, y los métodos pueden haber cambiado desde los artículos más antiguos.
- Los resultados descritos en una ficha de sistema los declara el propio desarrollador, salvo el trabajo atribuido a evaluadores externos identificados.
- La nota describe a un solo desarrollador. Otros proveedores publican materiales distintos, y la comparación con la práctica de quien despliega es una síntesis, no una conclusión de las fuentes.
El papel de FireAI y de HisnLabs
Las pruebas del modelo terminan en la API. A qué puede acceder una app o un agente desde tu Mac es un control distinto, y FireAI lo proporciona.
FireAI es el propio producto de HisnLabs: un cortafuegos con IA integrada para Mac. Muestra, en lenguaje claro, cada conexión que hacen tus aplicaciones y te deja decidir qué sale de tu Mac; su IA funciona en el propio equipo, así que tu tráfico nunca se envía a HisnLabs ni a nadie más. El equipo de investigación en seguridad de HisnLabs es quien mantiene esas decisiones fiables: cataloga qué dominios son simple telemetría frente a un servicio real, sigue el país y la red detrás de una conexión, y entrena el modelo local (la función FireAI Pilot) con tráfico real, sin que nada salga de tu Mac.
Puedes leer las decisiones técnicas detrás de esto, o probar FireAI durante 17 días, en FireAI, de HisnLabs.