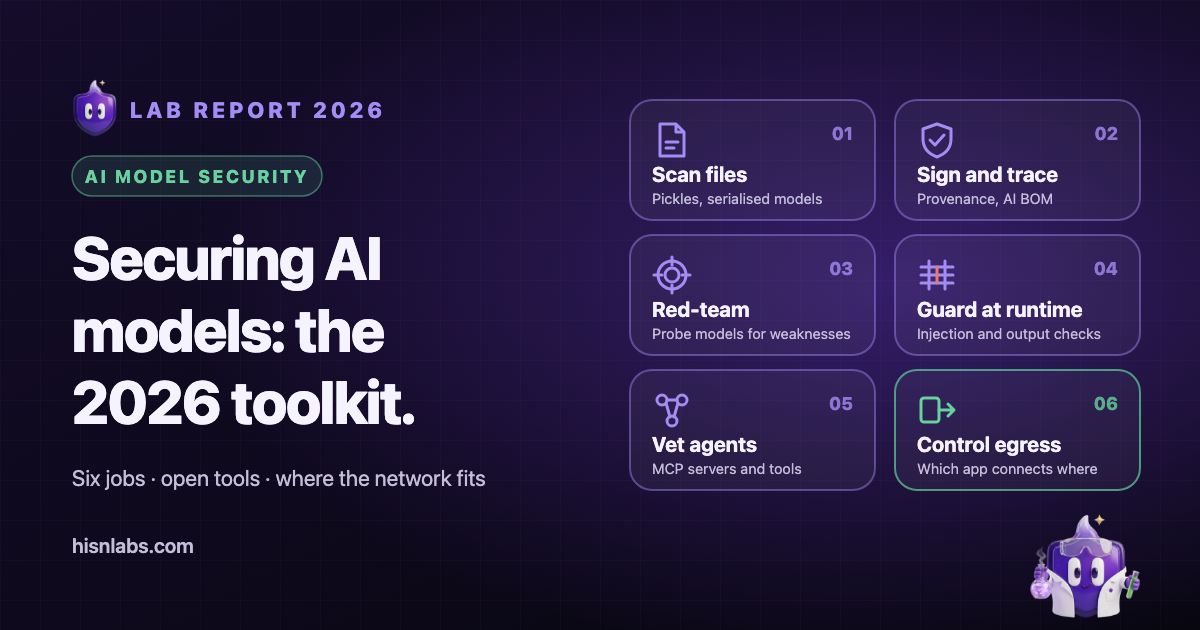
Die Sicherheit von KI-Modellen ist keine einzelne Disziplin, sondern umfasst sechs Aufgaben mit jeweils eigenen Werkzeugen: Modelldateien scannen, die Herkunft belegen, ein Modell auf Schwächen prüfen, es zur Laufzeit absichern, die Agenten-Werkzeuge in seinem Umfeld prüfen und begrenzen, wohin sich die ausführende Anwendung verbinden darf. Dieser Überblick, erstellt von HisnLabs, dem Entwickler von FireAI, behandelt offene Werkzeuge, deren Repositorys oder Dokumentation am 30. September 2026 gelesen wurden. Lizenzen, Betreuer und Status werden so angegeben, wie die Primärquellen sie nennen, und kein Werkzeug wird über ein anderes gestellt, da die Aufgaben nicht miteinander konkurrieren.
Umfang und Methode
Ein Werkzeug wurde nur aufgenommen, wenn sein offizielles Repository oder seine Dokumentation geöffnet, seine Lizenz ermittelt und sein Wartungszustand geprüft werden konnte (archiviert oder aktiv, und das Datum der neuesten Version, sofern die Release-Seite eines angibt). Die unten genannten Versionen sind die zum Zeitpunkt der Lektüre neuesten. Nichts hier ist eine Leistungsmessung: Die Quellen liefern keine vergleichbaren Erkennungsergebnisse, und es werden keine behauptet. Kommerzielle Plattformen sind ausgenommen, sofern nicht eine offene Komponente Gegenstand ist.
Die Kategorien folgen der Reihenfolge, in der ein Modell ein Projekt durchläuft: Eine Datei wird heruntergeladen, ihre Herkunft geprüft, das Modell getestet, hinter Schutzmechanismen bereitgestellt und mit Werkzeugen verbunden, und die Anwendung, die es ausführt, greift auf das Netzwerk zu. Die OWASP Top 10 for Large Language Model Applications, gepflegt im OWASP GenAI Security Project, bilden das übliche gemeinsame Vokabular für die Risiken auf Anwendungsebene in den Kategorien drei bis fünf.
1. Scannen von Modelldateien
Viele Modelldateien werden im Pickle-Format von Python serialisiert, das beim Laden Code ausführen kann. Die Dokumentation von Hugging Face hält fest, dass das Laden einer Pickle-Datei „means that code can be executed“, und nennt die Opcodes GLOBAL, STACK_GLOBAL und REDUCE als diejenigen, von denen die Gefahr ausgeht. Hugging Face: Pickle scanning Scanner lesen die Anweisungen der Datei, ohne sie zu laden, und markieren gefährliche Importe.
ModelScan
ModelScan wird von Protect AI unter der Lizenz Apache-2.0 gepflegt. Es scannt Pickle-basierte Formate (PyTorch, scikit-learn, XGBoost, joblib, cloudpickle), TensorFlow SavedModel sowie Keras-Dateien in H5 und V3, ordnet Befunde nach Schweregrad und beendet sich mit Exit-Codes, die sich für CI-Pipelines eignen. Die neueste Version auf der Projektseite ist v0.8.8 vom 18. Februar 2026, und das Repository zeigte am 28. September 2026 Aktivität. Es eignet sich als Kontrollpunkt, bevor ein heruntergeladenes Modell in einen Build gelangt. Einschränkung: Das README beschreibt eine signaturbasierte Erkennung, die falsch positive und falsch negative Ergebnisse liefern kann, und Befunde erfordern eine menschliche Prüfung.
picklescan
picklescan ist ein MIT-lizenzierter Scanner, der von einem Einzelkonto, mmaitre314, gepflegt wird. Die Dokumentation von Hugging Face führt picklescan unter den Werkzeugen auf, die für den Hub entwickelt wurden. Die neueste Version ist v1.0.5 vom 1. Juli 2026. Es scannt Pickle-Dateien, PyTorch-Archive und ZIP-Container und kann einen lokalen Pfad, eine URL oder ein Hugging-Face-Modell prüfen. Es eignet sich für eine schnelle Prüfung in einem Skript. Einschränkung: Es erkennt gefährliche Operationen anhand von Mustern, sodass eine neue Technik unentdeckt bleiben kann, und es meldet Befunde, ohne sie zu entfernen.
fickling
fickling von Trail of Bits steht unter der Lizenz LGPL-3.0. Es wird als Decompiler, statischer Analysator und Bytecode-Umschreiber für Pickle beschrieben. Es kann eine Pickle-Datei in lesbares Python dekompilieren, die Sicherheit per statischer Analyse prüfen und vor dem Laden einer unsicheren Datei einen Fehler auslösen. Die neueste Version ist v0.1.12 vom 26. Juni 2026. Es eignet sich, wenn ein Befund verstanden und nicht nur markiert werden muss. Einschränkung: Es ist ein Analysewerkzeug für Pickle und deckt die anderen Formate, die ModelScan liest, nicht ab. Seine Lizenzbedingungen unterscheiden sich von den permissiven Lizenzen der anderen Scanner.
Scannen auf dem Hugging Face Hub und safetensors
Der Hub scannt jede hochgeladene Datei mit ClamAV und mit einem Pickle-Import-Scan, der die Importe in jeder Pickle-Datei auflistet und verdächtige hervorhebt. Hugging Face: file scanning Für öffentliche Repositorys zeigt er außerdem Ergebnisse eines Drittanbieter-Scanners, Guardian von Protect AI. Hugging Face: Protect AI Einschränkung, wie Hugging Face sie formuliert: Der Pickle-Scan ist nicht völlig narrensicher, seine Listen werden nach bestem Bemühen gepflegt, und es liegt in der Verantwortung der Nutzer zu prüfen, was sicher ist. Die strukturelle Alternative ist safetensors, ein von Hugging Face gepflegtes Format unter Apache-2.0, das Tensoren ohne ausführbaren Inhalt speichert. Es beseitigt das Pickle-Risiko für Gewichte, sagt aber nichts darüber aus, ob die Gewichte selbst vertrauenswürdig sind.
2. Herkunft, Signierung und Fingerprinting von Modellen
Ein Scan fragt, ob das Laden einer Datei gefährlich ist. Die Herkunftsprüfung fragt, wer sie erstellt hat und ob sie sich seitdem verändert hat. Die beiden Fragen erfordern unterschiedliche Werkzeuge.
Sigstore model-transparency
model-transparency ist ein Projekt unter Apache-2.0 in der Sigstore-Organisation, das Machine-Learning-Modelle signiert und verifiziert. Es kann über Sigstore oder mit Schlüsseln, Zertifikaten oder PKCS #11-Geräten signieren und erzeugt ein Bundle mit einem DSSE-Umschlag, der eine in-toto-Aussage enthält. Die neueste Version ist v1.1.1 vom 10. Oktober 2025, mit Commits im September 2026. Es eignet sich, damit Empfänger prüfen können, dass die vorliegenden Dateien diejenigen sind, die ein Herausgeber signiert hat. Einschränkungen: Die Dokumentation nennt Unterstützung für das Hashen von Dateien und Datei-Shards, nicht von einzelnen Tensoren, und eine gültige Signatur belegt Herkunft und Integrität, nicht die Sicherheit des Modells. Hugging Face trifft dieselbe Unterscheidung für signierte Commits, die „the origin of the file“ garantieren, nicht aber, dass sie sicher ist.
Stücklisten für KI und ML
CycloneDX, gepflegt von der OWASP Foundation und dem TC54 von Ecma International, führt eine Machine Learning Bill of Materials (ML-BOM) unter seinen unterstützten BOM-Typen. Die neueste Version, 1.7, erschien am 21. Oktober 2025, und die Schemas stehen unter Apache-2.0. Das SPDX 3.0 AI profile dokumentiert KI-Komponenten wie Modelle, Datensätze und Prompts in einem zusammenhängenden Datensatz. Beide eignen sich, um ein Verzeichnis darüber zu führen, welche Modelle, Datensätze und Versionen ein Produkt enthält, also das, was eine Vorfallsreaktion zuerst benötigt. Einschränkung: Eine BOM erfasst, was ein Autor angibt. Keines der Formate verifiziert diese Angabe.
Forschungswerkzeuge für Fingerprinting und Watermarking
Instructional Fingerprinting ist der Code einer wissenschaftlichen Arbeit (arXiv 2401.12255), die einen Fingerabdruck in ein Sprachmodell einbettet, sodass ein Eigentümer später prüfen kann, ob ein anderes Modell davon abgeleitet ist. Es handelt sich um MIT-lizenzierten Forschungscode, dessen Repository zuletzt im Juli 2024 aktualisiert wurde. MarkLLM der Gruppe THU-BPM ist ein Toolkit unter Apache-2.0 zum Watermarking des von einem LLM erzeugten Textes, vorgestellt als Demo auf der EMNLP 2024. Beide beantworten unterschiedliche Fragen: Das erste kennzeichnet ein Modell, das zweite seine Ausgabe. Sie eignen sich zur Erforschung der Zuordnung, nicht als Produktionskontrolle. Einschränkung: Beide sind Forschungsartefakte, und keines ersetzt die Signierung einer verteilten Datei.
3. LLM-Red-Teaming und Schwachstellenscans
Diese Werkzeuge senden adversariale Eingaben an ein Modell oder eine Anwendung und protokollieren die Reaktion. Sie prüfen Verhalten, keine Dateien.
garak
garak ist ein von NVIDIA gepflegter LLM-Schwachstellenscanner unter Apache-2.0. Laut README prüft er, „if an LLM can be made to fail in a way we don’t want“, mit Probes für Prompt-Injection, Datenabfluss, Halluzination, Toxizität und Jailbreaks, die jeweils mit einem Detektor gekoppelt sind. Die neueste Version ist v0.17.0 vom 9. September 2026. Er eignet sich als breiter Basisscan eines Modell-Endpunkts. Einschränkungen: Er benötigt API-Zugriff oder eine lokale Bereitstellung des Ziels, einige Probes sind ressourcenintensiv, und das README nennt eingeschränkte Unterstützung für Bildmodelle sowie Prototypstatus einzelner Probes.
PyRIT
PyRIT ist ein MIT-lizenziertes Framework, das nach eigener Beschreibung für Sicherheitsfachleute und Ingenieure entwickelt wurde, um Risiken in generativen KI-Systemen zu erkennen. Es wird von Microsoft gepflegt, und die neueste Version ist v1.1.0 vom 4. September 2026. Das frühere Repository unter der Azure-Organisation wurde am 27. März 2026 mit einem Verweis auf das Microsoft-Repository archiviert; Links auf die alte Adresse führen daher zu einer schreibgeschützten Kopie. Es eignet sich für skriptgesteuerte, mehrstufige Red-Team-Kampagnen eines Teams, das selbst Code schreibt. Einschränkung: Es ist ein Framework, kein Scanner mit einem einzigen Befehl.
promptfoo
promptfoo ist ein MIT-lizenziertes Kommandozeilenwerkzeug und eine Bibliothek zur Evaluierung von LLM-Anwendungen sowie für Red Teaming und Schwachstellenscans, mit CI-Integration. Die neueste Version ist 0.123.1 vom 18. September 2026. Das README hält fest: „Promptfoo is now part of OpenAI. Promptfoo remains open source and MIT licensed.“ Es eignet sich, um Prompt-Tests und adversariale Prüfungen in einen Build aufzunehmen. Einschränkung: Die Ergebnisse hängen vom konfigurierten Anbieter und Bewertungsmodell ab, und die meisten Anbieter erfordern API-Schlüssel. Der Eigentümerwechsel ist ein Governance-Faktum, das bei der Werkzeugwahl für regulierte Arbeit Beachtung verdient.
Giskard
Giskard ist eine Python-Bibliothek unter Apache-2.0 der Organisation Giskard-AI. Version 3 hat zwei als stabil beschriebene Komponenten: giskard-checks, ein Testframework mit Szenarien und LLM-as-judge-Bewertungen, und giskard-scan, einen Scanner für Schwachstellen von Agenten. Es eignet sich zum Testen von Agenten- und Retrieval-Augmented-Systemen. Einschränkungen: Version 3 erfordert Python 3.12 oder neuer, und Version 2, die tabellarisches und klassisches Machine-Learning-Scanning abdeckte, wird nicht mehr aktiv gepflegt.
4. Laufzeit-Guardrails und Erkennung von Prompt-Injection
Guardrails liegen im Anfragepfad und klassifizieren oder beschränken Ein- und Ausgaben, während die Anwendung läuft.
Llama Guard, Prompt Guard und LlamaFirewall
Das Projekt Purple Llama von Meta bündelt Schutzmechanismen für offene Modelle. Llama Guard ist eine Familie von Moderationsmodellen für Ein- und Ausgaben. Prompt Guard 2 wird als leichtgewichtiger Klassifikator für direkte Prompt-Injection-Versuche beschrieben, und LlamaFirewall kombiniert ihn mit einem Scanner zur Alignment-Prüfung und einem Code-Scanner für Agenten. Laut Lizenztabelle des Projekts werden die Modelle unter Llama Community Licences verteilt, andere Komponenten wie Code Shield und die Evaluierungen unter MIT. Die Modelle auf Hugging Face sind zugangsbeschränkt. Sie eignen sich dort, wo ein kleiner Klassifikator vor einem Modell akzeptabel ist. Einschränkungen: Ein Klassifikator verringert Versuche, die bekannten Mustern ähneln, beseitigt aber nicht die Angriffsklasse.
NeMo Guardrails
NeMo Guardrails ist ein Toolkit unter Apache-2.0 von NVIDIA, um LLM-Anwendungen programmierbare Leitplanken hinzuzufügen; es nutzt eine Modellierungssprache namens Colang zur Steuerung des Dialogablaufs. Die neueste Version ist v0.24.1 vom 16. September 2026. Es eignet sich, um Themen, Formate und Dialogpfade einzuschränken. Einschränkung: Leitplanken sind vom Entwickler geschriebene Richtlinien, ihre Abdeckung reicht also nur so weit wie das, was vorhergesehen wurde.
Rebuff und LLM Guard, inzwischen archiviert
Rebuff, ein selbsthärtender Detektor für Prompt-Injection mit Heuristiken, einer LLM-Prüfung, einem Vektorspeicher früherer Angriffe und Canary-Tokens, wurde am 16. Mai 2025 archiviert. Das README hält fest, dass es ein Prototyp ist und keinen vollständigen Schutz vor Prompt-Injection bieten kann. LLM Guard, ein MIT-lizenziertes Toolkit mit Scannern für Ein- und Ausgaben vom selben Betreuer, wurde im Juli 2026 archiviert. Beide bleiben zu Referenzzwecken lesbar. Sie veranschaulichen einen praktischen Punkt: Detektorprojekte können ihre Betreuer verlieren, daher sollte eine Guardrail austauschbar sein.
5. Sicherheitsscanner für Agenten und MCP
Agenten fügen Werkzeuge hinzu, und Werkzeugbeschreibungen sind Text, den das Modell liest. Die Scanner dieser Gruppe untersuchen diese Werkzeuge und ihre Konfiguration.
Snyk Agent Scan
Agent Scan, früher MCP-Scan, ist ein von Snyk gepflegter Scanner unter Apache-2.0. Er erkennt Agentenkomponenten auf einem Rechner, darunter MCP-Server und Skills in Clients wie Claude, Cursor, VS Code und GitHub Copilot, und prüft sie auf Prompt-Injection, Tool Poisoning und verwandte Probleme. Die neueste Version ist v0.6.8 vom 29. September 2026. Er eignet sich, um zu prüfen, was auf einem Entwicklerrechner installiert ist. Einschränkungen: Das README hält fest, dass derzeit keine externen Beiträge angenommen werden und dass zwei Release-Linien mit unterschiedlichen Ausgabeformaten existieren.
Cisco MCP Scanner
MCP Scanner ist ein Werkzeug unter Apache-2.0 von Cisco AI Defense. Es analysiert MCP-Tools, Prompts, Ressourcen und Abhängigkeiten mit drei Engines, die einzeln oder gemeinsam laufen können: YARA-Regeln, LLM-Analyse und die Cisco AI Defense API. Die neueste Version ist 4.8.4 vom 28. August 2026. Es eignet sich zur Prüfung eines Servers vor der Einführung. Einschränkung: Die LLM- und API-Engines benötigen externe Zugangsdaten, und ein Scan der Beschreibung eines Servers sagt wenig darüber aus, was sein Code nach einem Update tut.
6. Die Rolle von Netzwerkkontrollen
Die oben genannten Werkzeuge untersuchen Dateien, Modelle, Prompts und Konfigurationen. Keines von ihnen entscheidet, welche Anwendung eine Verbindung zu welchem Server öffnen darf. Das ist die Aufgabe der Egress-Kontrolle, und sie ist wichtig, weil die Risiken der vorigen Abschnitte im Netzwerk zusammenlaufen: Eine manipulierte Modelllaufzeit, ein vergiftetes Werkzeug oder ein durch Injection beeinflusster Agent muss ein Ziel erreichen, um Daten abfließen zu lassen oder Anweisungen zu empfangen.
FireAI, entwickelt von HisnLabs, ist eine ausgehende Firewall für macOS. Sie läuft als Inhaltsfilter einer Apple Network Extension, identifiziert jede App anhand ihrer Code-Signatur und kann jedes Ziel erlauben, blockieren oder nachfragen, mit Regeln pro App, Domain oder Adresse. Auf KI-Arbeit am Mac angewandt bedeutet das, dass ein Inferenzserver, ein Coding-Agent oder ein MCP-Client auf die Ziele beschränkt werden kann, die seine Aufgabe erfordert, und dass ein neues Ziel eine Entscheidung auslöst. Die Dokumentation des Filters beschreibt, was FireAI sieht: App-Identität, entfernter Host oder Adresse, Port und Protokoll.
FireAI scannt keine Modelldateien, verifiziert keine Signaturen, führt kein Red Teaming an Modellen durch und klassifiziert keine Prompts. Es liest den Inhalt verschlüsselter Verbindungen nicht und kann daher eine legitime Anfrage nicht von einer injizierten unterscheiden, wenn beide an ein erlaubtes Ziel gehen. Es ergänzt die oben genannten Werkzeuge und ersetzt keines davon.
Vergleich
| Werkzeug | Aufgabe | Betreuer | Lizenz | Status am 30 Sep 2026 |
|---|---|---|---|---|
| ModelScan | Scannen von Modelldateien | Protect AI | Apache-2.0 | Aktiv, v0.8.8 |
| picklescan | Pickle-Scan | mmaitre314 | MIT | Aktiv, v1.0.5 |
| fickling | Pickle-Analyse | Trail of Bits | LGPL-3.0 | Aktiv, v0.1.12 |
| safetensors | Sicheres Gewichtsformat | Hugging Face | Apache-2.0 | Aktiv |
| model-transparency | Signierung von Modellen | Sigstore | Apache-2.0 | Aktiv, v1.1.1 |
| CycloneDX | ML-BOM-Spezifikation | OWASP, Ecma TC54 | Apache-2.0 (Schemas) | Aktiv, 1.7 |
| Instructional Fingerprinting | Modell-Fingerabdruck (Forschung) | Autoren der Arbeit | MIT | Letzte Aktualisierung Juli 2024 |
| MarkLLM | Text-Watermarking (Forschung) | THU-BPM | Apache-2.0 | Aktiv |
| garak | Schwachstellenscan | NVIDIA | Apache-2.0 | Aktiv, v0.17.0 |
| PyRIT | Red-Team-Framework | Microsoft | MIT | Aktiv, v1.1.0 |
| promptfoo | Evaluierung und Red Teaming | Promptfoo, Teil von OpenAI | MIT | Aktiv, 0.123.1 |
| Giskard v3 | Agententests und Scan | Giskard-AI | Apache-2.0 | Aktiv; v2 nicht mehr gepflegt |
| Llama Guard, Prompt Guard | Schutzmodelle | Meta | Llama Community Licences | Modelle vom April 2025 |
| NeMo Guardrails | Programmierbare Leitplanken | NVIDIA | Apache-2.0 | Aktiv, v0.24.1 |
| Rebuff, LLM Guard | Injection-Erkennung | Protect AI | Apache-2.0, MIT | Archiviert |
| Agent Scan | Scan von Agenten und MCP | Snyk | Apache-2.0 | Aktiv, v0.6.8 |
| MCP Scanner | Scan von MCP-Servern | Cisco AI Defense | Apache-2.0 | Aktiv, 4.8.4 |
| FireAI | Egress-Kontrolle pro App unter macOS | HisnLabs | Kommerziell | Scannt keine Modelle |
Einschränkungen
- Kein einzelnes Werkzeug deckt alle sechs Aufgaben ab. Ein unauffälliger Dateiscan sagt nichts über das Verhalten eines Modells, eine Signatur nichts über Sicherheit und ein Red-Team-Scan nichts über den Inhalt einer Datei.
- Scanner und Schutzmechanismen sind Detektoren. Sie können neue Techniken übersehen, wie die Dokumentationen von ModelScan, picklescan und Rebuff jeweils einräumen, und ihre Abdeckung ändert sich, wenn sich Angriffe ändern.
- Die Wartung ist ungleichmäßig. Zwei hier aufgeführte Detektorprojekte sind archiviert, ein Werkzeug hat den Eigentümer gewechselt, eines wird von einer Einzelperson gepflegt, und ein Forschungs-Repository hat sich seit 2024 nicht verändert. Prüfen Sie den Zustand eines Projekts, bevor Sie darauf aufbauen.
- Dieser Überblick beschränkt sich auf offene Werkzeuge mit lesbaren Primärquellen. Er schließt kommerzielle Plattformen aus und vergleicht keine Erkennungsergebnisse, da die Quellen keine vergleichbaren Zahlen liefern.
- Die Lizenzen wurden auf Repository-Seiten und in Lizenztabellen gelesen. Prüfen Sie sie vor einer Weiterverbreitung, insbesondere die Llama Community Licences und die LGPL-Bedingungen von fickling.
- Die Netzwerkebene sieht Verbindungen, keine Bedeutung. Ein erlaubtes Ziel kann dennoch Daten von einer kompromittierten Modelllaufzeit empfangen.
Wo FireAI und HisnLabs ins Spiel kommen
Das Modell scannen, das Modell signieren, das Modell testen. Danach entscheiden, wohin sich seine App verbinden darf.
FireAI ist das eigene Produkt von HisnLabs: eine KI-Firewall für den Mac, die direkt auf dem Gerät läuft. Sie zeigt jede Verbindung Ihrer Apps in verständlicher Sprache und lässt Sie entscheiden, was Ihren Mac verlässt — die KI arbeitet lokal, Ihr Datenverkehr wird also nie an uns oder irgendjemand anderen gesendet. Das Sicherheitsforschungsteam von HisnLabs sorgt dafür, dass diese Entscheidungen verlässlich bleiben: Es katalogisiert, welche Domains gewöhnliche Telemetrie und welche ein echter Dienst sind, verfolgt Land und Netzwerk hinter einer Verbindung und trainiert das lokale Modell (die FireAI-Pilot-Funktion) mit echten Verkehrsmustern — ohne dass irgendetwas davon Ihren Mac verlässt.
Die technischen Entscheidungen dahinter können Sie nachlesen — oder FireAI 17 Tage lang ausprobieren — unter FireAI, von HisnLabs.