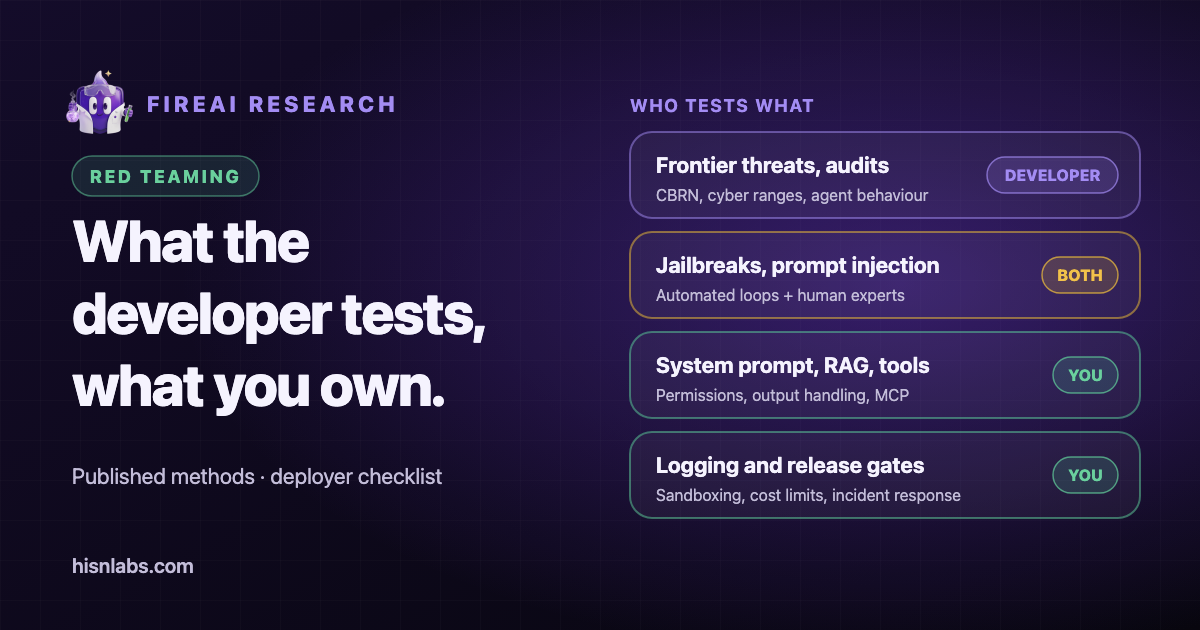
تنشر Anthropic عن طريقة اختبارها لـ Claude أكثر مما ينشره معظم مطوّري النماذج: تدوينات عن اختبار الفريق الأحمر، وسياسة التوسع المسؤول (Responsible Scaling Policy)، وبطاقات نظام لكل نموذج. تلخّص هذه المذكرة تلك الوثائق، وتميّز بين ثلاث مجموعات من الأعمال: أساليب يستخدمها المطوّرون والجهات المشغّلة على حد سواء، وأعمال لا يستطيع القيام بها إلا المطوّر، وأعمال تبقى على عاتق المؤسسة التي تبني تطبيقًا على النموذج. أما العمليات الداخلية التي تتجاوز ما نشرته Anthropic فلا تظهر للقراء من الخارج ولا توصف هنا. وهذه المذكرة هي النصف الثاني من ثنائية مع Shared responsibility for LLMs: who secures what.
الخلفية: سؤالان مختلفان
يسأل مطوّر النموذج عمّا إذا كان النموذج خطرًا: هل يمكنه تقديم عون جدي لتطوير الأسلحة، أو تنفيذ عمليات سيبرانية، أو التصرف بخداع. أما الجهة المشغّلة فتسأل عمّا إذا كان تطبيقها آمنًا: هل يمكن لوثيقة مصممة بعناية، أو نتيجة أداة، أو رسالة مستخدم، أن تجعل التطبيق يسرّب بيانات أو يتخذ إجراءً لا ينبغي له. تتداخل الأساليب، لكن السؤالين والأدلة يختلفان، والنتيجة الناجحة في السؤال الأول لا تجيب عن الثاني.
ما تصفه Anthropic
أساليب تتداخل مع ممارسات الجهات المشغّلة
في تدوينة بتاريخ 12 يونيو 2024، تصنّف Anthropic أعمال الفريق الأحمر لديها إلى اختبار يجريه خبراء في مجالات محددة، واختبار يستخدم نماذج لغوية، وأعمال على وسائط جديدة، ونُهج مفتوحة. ويستخدم اختبار الفريق الأحمر المؤتمت ديناميكية فريق أحمر وفريق أزرق يولّد فيها نموذجٌ الهجمات. وغطى اختبار الفريق الأحمر متعدد الوسائط مخاطر الصور والنصوص في نماذج Claude 3 قبل نشرها. وشمل الاختبار متعدد اللغات شراكة مع هيئة تطوير وسائل الإعلام والمعلومات والاتصالات في سنغافورة (IMDA) عبر أربع لغات: الإنجليزية والتاميلية والماندرين والملايوية. وتذكر Anthropic أيضًا اختبار الفريق الأحمر الجماعي والمجتمعي، ومنه فعاليات في AI Village ضمن مؤتمر DEF CON. [1]
تُظهر بطاقة نظام Claude Opus 5، المؤرخة في 24 يوليو 2026، الأساليب نفسها مطبّقة على إصدار واحد. يستخدم فصل الضمانات فيها طلبات منفردة ضارة وحميدة، وأوامر ذات سياق ملتبس، ومحادثات متعددة الجولات يوجّهها مستخدم محاكى تدريجيًا نحو الضرر. ويعرض عدم الإضرار جنبًا إلى جنب مع الرفض المفرط، فيذكر أن النموذج حافظ على معدلات مرتفعة من الاستجابات غير الضارة للطلبات الضارة، مع بقائه من بين الأدنى في معدلات الرفض المفرط للطلبات الحميدة. ويغطي فصل السلامة في العمل الوكيلي إساءة استخدام وكلاء البرمجة واستخدام الحاسوب، ومتانة النموذج أمام حقن الأوامر في البرمجة واستخدام الحاسوب واستخدام المتصفح. [7]
تعرّف بطاقة النظام حقن الأوامر بأنه تعليمة خبيثة مخبأة في نتائج أدوات يعالجها الوكيل، وتشير إلى أن الخطر يبلغ ذروته حين يستطيع الوكيل الوصول إلى بيانات خاصة والتصرف نيابة عن المستخدم معًا. وتفيد أيضًا بأن تعليمات السلامة في أمر النظام على claude.ai عززت تعامل النموذج مع الطلبات الضارة مقارنة بواجهة API من دون أمر نظام. [7] والنتيجة الثانية تمسّ الجهات المشغّلة مباشرة، لأن أمر النظام جزء من الجانب الذي تتولاه.
تحدد سياسة التوسع المسؤول، الإصدار 3.4 الساري منذ 8 يوليو 2026، عتبات القدرات مسبقًا، وتشترط تقييمات رسمية كل ستة أشهر، وتنص على مراجعين خارجيين لتقارير المخاطر. [4] وتحديد العتبات قبل الاختبار يحدّ من إغراء إعادة تفسير النتيجة بعد وقوعها، وهي ممارسة قابلة للنقل إلى أي مؤسسة تضع معايير للإصدار.
أعمال لا يستطيع القيام بها إلا مطوّر النموذج
يستهدف اختبار الفريق الأحمر للتهديدات الحدّية المخاطرَ الكيميائية والبيولوجية والإشعاعية والنووية (CBRN)، والأمن السيبراني، ومخاطر الذكاء الاصطناعي المستقل. وتصف تدوينة من عام 2023 خبراء في مجالاتهم يملكون عقودًا من الخبرة يحددون نماذج التهديد، وأكثر من 100 ساعة من الفحص على يد الخبراء، ودراسة في الأمن البيولوجي امتدت ستة أشهر وتجاوزت 150 ساعة. [3] وتصف تدوينة من مارس 2025 تقييمات سيبرانية قائمة على تحديات «التقاط العلم» وبيئات شبكية محاكاة، وتذكر أن Frontier Red Team عمل مع US AI Safety Institute وUK AI Security Institute والإدارة الوطنية الأمريكية للأمن النووي (NNSA)، وكان العمل مع الأخيرة على تقييمات سرية للمعرفة النووية والإشعاعية. [2]
يذكر Transparency Hub لدى Anthropic أن الشركة تستخدم اختبار الفريق الأحمر الداخلي والخارجي معًا، وأن UK AI Security Institute وUS Center for AI Standards and Innovation وModel Evaluation and Threat Research (METR) أجرت اختبارات إضافية على نماذجها. ويدرج أيضًا برامج مكافآت الثغرات على HackerOne. [5] وتتضمن بطاقة نظام Opus 5 اختبارًا في ميدان سيبراني من UK AI Security Institute، وتقييمًا للمواءمة قائمًا على تدقيق سلوكي مؤتمت، إضافة إلى فصل عن رفاه النموذج. [7] ولا تذكر صفحة Transparency Hub أي معهد اختبر نموذجًا بعينه قبل إصداره، فلا يُثبت هنا دور كل منها قبل النشر بما يتجاوز ما تفيد به بطاقة النظام.
الاختبار الخارجي والجماعي فئة مستقلة. تفيد HackerOne بأن تحدي كسر القيود الذي أطلقته Anthropic جرى من 3 إلى 10 فبراير 2025 بمشاركة 339 شخصًا، وبأكثر من 300,000 تفاعل محادثة، وثمانية مستويات صعوبة، وبأن أربعة فرق تقاسمت 55,000 دولار أمريكي من المكافآت. ومن التقنيات الناجحة: الأوامر المرمّزة والشيفرات، ولعب الأدوار، واستبدال كلمات مفتاحية ضارة بأخرى حميدة، وحقن الأوامر. [6] وبالنسبة إلى Opus 5، تسمّي بطاقة النظام ثلاثة مختبِرين خارجيين متعاقدين: أمضى الأول نحو 100 ساعة وأنجز مهمة واحدة بأوامر مخصصة للمهمة، وأمضى الثاني نحو 16 ساعة من دون كسر ناجح للقيود، وشغّل الثالث مهاجمًا مؤتمتًا بمعدل 150 محاولة لكل مهمة من دون نجاح. [7]
ما يبقى على عاتق الجهات المشغّلة
لا يقيّم أيٌّ من اختبارات المطوّر السابقة تطبيقًا بعينه. فالأمور التالية تبقى على عاتق المؤسسة التي تشغّل النموذج، وتشير بطاقة النظام نفسها إلى عدد منها، مثلًا بإظهارها أن أوامر النظام تغيّر سلوك النموذج، وأن الوكلاء يكونون في أشد حالات التعرض حين يجمعون بين البيانات الخاصة والقدرة على التصرف. [7]
- أمر النظام وضوابطه، بما في ذلك سلوكها تحت ضغط متعدد الجولات.
- بيانات RAG وحقن الأوامر غير المباشر: فأي وثيقة أو صفحة أو بريد إلكتروني يُسترجع إلى السياق يمكن أن يحمل تعليمات.
- الأدوات، وصلاحيات الوكيل، وما يمكن لتعليمة محقونة أن تفعله بها.
- معالجة مخرجات النموذج قبل وصولها إلى متصفح أو سطر أوامر أو قاعدة بيانات أو إنسان.
- سلسلة التوريد، بما فيها الإضافات من أطراف ثالثة وخوادم Model Context Protocol (MCP).
- إساءة استخدام التكلفة، كالحلقات غير المحدودة أو الطلبات التي تستهلك رموزًا مدفوعة.
- عزل تنفيذ الشيفرة والتصفح، والتحكم في الوصول الشبكي الصادر.
- التسجيل والمراقبة وبوابات الإصدار التي تقرر متى يمكن طرح التغيير.
ممارسات تستحق الاقتباس
- استعن بمختبِري فريق أحمر خارجيين، أو أطلق برنامج مكافآت ثغرات خاصًا، قبل الإصدارات الكبرى. فممارسة Anthropic نفسها تشمل الأمرين: مختبِرين خارجيين متعاقدين لكل إصدار، وتحديًا علنيًا لكسر القيود بمكافآت.
- أجرِ فحصًا سلوكيًا على غرار فحوص المواءمة للوكلاء: خذ عيّنات من سجلات استخدام الأدوات وابحث عن محاولات لتجاوز القيود، كما فعلت مراقبة Anthropic في النشر الداخلي.
- اكتب بطاقة نظام داخلية قصيرة لكل إصدار: ما الذي اختُبر، وأي الاختبارات أخفقت، والرفض المفرط إلى جانب الضرر، والفجوات المعروفة.
- حدد عتبات الإصدار قبل الاختبار، على نهج سياسة التوسع المسؤول.
- اختبر حقن الأوامر عبر كل قناة يقرؤها الوكيل، لا مدخلات المستخدم وحدها.
يغطي مقرر FireAI University عن أطر أمن الذكاء الاصطناعي واختبار الفريق الأحمر هذه الأساليب بتفصيل أكبر.
صلة ذلك بـ FireAI
يعمل FireAI على جهاز Mac، تحت أي نموذج. القواعد تسمح لتطبيق ما أو تحظره، أو تسمح بوجهة واحدة لذلك التطبيق أو تحظرها، فيمكن حصر أداة ذكاء اصطناعي محلية في المضيفين الذين تحتاج إليهم. وهذا يحدّ من الأماكن التي يمكن أن تذهب إليها البيانات إذا أساء تطبيق التصرف. لا يختبر FireAI النماذج، ولا يرصد حقن الأوامر، ولا يقرأ الأوامر، ولا يرشّح مخرجات النماذج.
القيود
- تعتمد المذكرة فقط على ما نشرته Anthropic وHackerOne. أما العمليات الداخلية لدى Anthropic بما يتجاوز ذلك فغير مرئية، والملخصات المنشورة انتقائية.
- تختلف المصادر في تواريخها، من يوليو 2023 إلى يوليو 2026، وربما تغيرت الأساليب منذ التدوينات الأقدم.
- النتائج الموصوفة في بطاقة النظام يبلّغ عنها المطوّر بنفسه، باستثناء الأعمال المنسوبة إلى مختبِرين خارجيين مسمّين.
- تصف المذكرة مطوّرًا واحدًا. وينشر مزودون آخرون مواد مختلفة، والمقارنة بممارسات الجهات المشغّلة توليف، لا نتيجة مستخلصة من المصادر.
دور FireAI وHisnLabs
ينتهي اختبار النموذج عند واجهة API. أما ما يحق لتطبيق أو وكيل الوصول إليه من جهاز Mac فضابط منفصل، يوفره FireAI.
FireAI هو منتج HisnLabs نفسها: جدار حماية بذكاء اصطناعي يعمل على جهاز Mac مباشرة. يعرض بلغة واضحة كل اتصال تجريه تطبيقاتك، ويترك لك القرار فيما يخرج من جهازك — ذكاؤه الاصطناعي يعمل محليًا، فلا يُرسَل ترافيكك إلينا ولا إلى أي جهة أخرى أبدًا. فريق أبحاث الأمن في HisnLabs هو من يحافظ على دقة هذه القرارات: يصنّف النطاقات بين قياس عن بُعد عادي وخدمة حقيقية، ويتتبّع بلد وشبكة كل اتصال، ويدرّب النموذج المحلي (ميزة FireAI Pilot) على حركة اتصال حقيقية، دون أن يغادر أي شيء جهاز Mac.
يمكنك الاطلاع على القرارات التقنية وراء ذلك، أو تجربة FireAI لمدة 17 يومًا، على FireAI من HisnLabs.